Causal Video Group · Literature Review

Multi-Shot
Video Generation

From Joint Denoising to Online Directing · 2023–2026

Holistic JointShot-Level ARCausal StreamingSystem / Agent
SHOT 01ESTABLISHING WIDE
SHOT 02CLOSE-UP
SHOT 03REVERSE OTS

好镜头只是起点:
变化要有镜头语言,一致性要跨越 cuts。

01 · Task boundary

Multi-shot:有明确镜头边界的连续叙事生成

Input
全局故事 / 角色设定 + 按顺序排列的 per-shot descriptions
Output
由 hard cut 分隔的多个 shots;视角、构图、动作或时空可改变
SHOT 01WIDE · 建立空间
SHOT 02CLOSE-UP · 强调表情
SHOT 03REVERSE · 切换视点
≠ Long video

long video 强调持续时间;multi-shot 强调镜头边界与镜头间依赖。

≠ Multi-scene

scene 是叙事时空单位,一个 scene 可以包含多个 shots。

≠ Story video

本报告限定为显式建模 shot boundary 与 shot-level dependency 的视频方法。

核心难点:consistency
不是所有镜头都相似,而是“该保持的保持、该变化的变化”。

02 · Unified framework

四类方法,也是报告的四个 Part

前三类看 shots 如何生成、历史怎样进入视频模型;第四类看模型外部怎样规划、检查与纠错。

PART I · 04–10
Holistic Joint

一个双向模型,一次调用联合生成全部 shots。

all shots ↔ all shots
PART II · 11–16
Shot-Level AR

模型多次调用,每轮生成一个完整 shot。

shotᵢ ← finished shots<ᵢ
PART III · 17–21
Causal Streaming

按 frame / chunk 因果 rollout,复用有界状态。

chunkᵢ ← causal state<ᵢ
PART IV · 22–27
System / Agent

模型之外规划、管理参考、检查、重试。

plan → render → inspect ↻
关键边界:shot 内双向 diffusion 的 shot-AR,不等于 causal streaming;System 与前三类正交。
综合比较 · 28–30:trade-off、benchmark 现状与讨论。

PART I

Holistic Joint Generation

所有 shots 在一次调用中双向统一去噪

Shot plancaptions · boundary · duration
→
Joint DiTall visual tokens ↔ all visual tokens
→
Multi-shot videono rollout error accumulation
共同接口
inference 前通常给定 per-shot captions 与边界。
核心问题
caption–shot alignment。
主要代价
总 token 扩展、完整脚本、局部修改需重算。

04 · Evolution

从对齐原语,到长时与导演控制

2024.12
时间化事件控制
MinTCVPR 2025event captions 对齐一条联合视频
2025.03–05
对齐与边界原语
LCTICCV 2025interleaved RoPE
Mask²DiTCVPR 2025text–segment mask
ShotAdapterCVPR 2025transition token
2025.06–08
面向具体问题
EchoShotNeurIPS 2025portrait identity alignment
CineTransICLR 2026真实电影 hard cuts
2025.10–12
规模与导演控制
HoloCineCVPR 2026分钟级 joint context
MultiShotMasterCVPR 2026reference grounding
ShotDirectorCVPR 2026transition 与 camera control
2026.03–06
规划器与音视频生成汇合
ShotVersearXiv自动规划相机轨迹
MAVINarXiv画面、声音与角色绑定
跨-shot consistency 始终是目标。演进的是局部语义、更长上下文与导演级控制。

Caption–shot alignment

Attention mask:显式规定“谁可以看谁”

Mask²DiTCVPR 2025

同时满足两件事:每个 shot 只接收自己的 caption;所有 shots 仍能共享视觉信息来保持一致性。

CAP 1
CAP 2
CAP 3
VISUAL
SHOT 1
align
×
×
full
SHOT 2
×
align
×
full
SHOT 3
×
×
align
full
CineTransICLR 2026

只在部分 DiT 层使用 visual block-diagonal mask:被遮罩层强化 hard cut,未遮罩层继续跨 shot 传递全局信息。

ShotDirectorCVPR 2026

Global–Local Shot-Aware Mask:人物、故事与转场文本对全部 shots 可见;摄影和相机描述只对所属 shot 可见。

推理接口
mask 直接编码边界,但 cut positions 仍需预先确定。

Caption–shot alignment

Special RoPE:不隔断 attention,重写位置几何

LCTICCV 2025
ACTUAL TOKEN ORDERscene tokens →
Caption 1E₁
Noisy video 1V₁(t,h,w)
|
Caption 2E₂
Noisy video 2V₂(t,h,w)
|
Caption 3E₃
Noisy video 3V₃(t,h,w)
[ caption₁, noise₁ ]
[ caption₂, noise₂ ]
[ caption₃, noise₃ ]
Interleaved 3D RoPE = local 3D position + pair-specific offset
Pair 1 · offset Δ₁local (t,h,w) + Δ₁
caption₁ 与 video₁ 落在同一位置块。
Pair 2 · offset Δ₂local (t,h,w) + Δ₂
整体移到不重叠的下一位置块。
Pair 3 · offset Δ₃local (t,h,w) + Δ₃
pair 内几何不变,pair 间顺序可辨。
EchoShotNeurIPS 2025

SaRoPE 标记 shot-local time 与 cut;TaRoPE 让 caption 与视频区间共享 shot identity。

Narrative RoPE 用固定 phase shift 标边界;STPA RoPE 将 reference 绑定到指定 shot / time / region。

为什么有效?
模型能区分连续运动的“下一帧”和新镜头重新开始的局部时间。

Caption–shot alignment

Transition token:给 cut 一个显式、可学习的控制信号

ShotAdapterCVPR 2025
Caption 1
frames
Visual
tokens
TT₁
cut
Caption 2
frames
Visual
tokens
TT₂
cut
Caption 3
frames

K 个 shots 对应 K−1 个 Transition Token;数量只是接口关系,重点是 TT 与 local mask 的分工。

边界在哪里?
duration + local mask 决定每条 caption 的负责区间。
边界做什么?
Transition Token 强化“这里执行切镜”的可学习信号。

关键消融:去掉 TT、保留 local mask,仍能生成 multi-shot。

TT 是控制手柄而非唯一来源;训练仍以人工拼接的 2–3-shot 为主。

Scaling the joint context

HoloCineCVPR 2026:主要贡献是把 Holistic Joint 拉到更长时间

≈60s
training coverage

数据按约 5 / 15 / 60 秒分档;最长训练样本最多包含约 13 shots。不是推理硬上限。

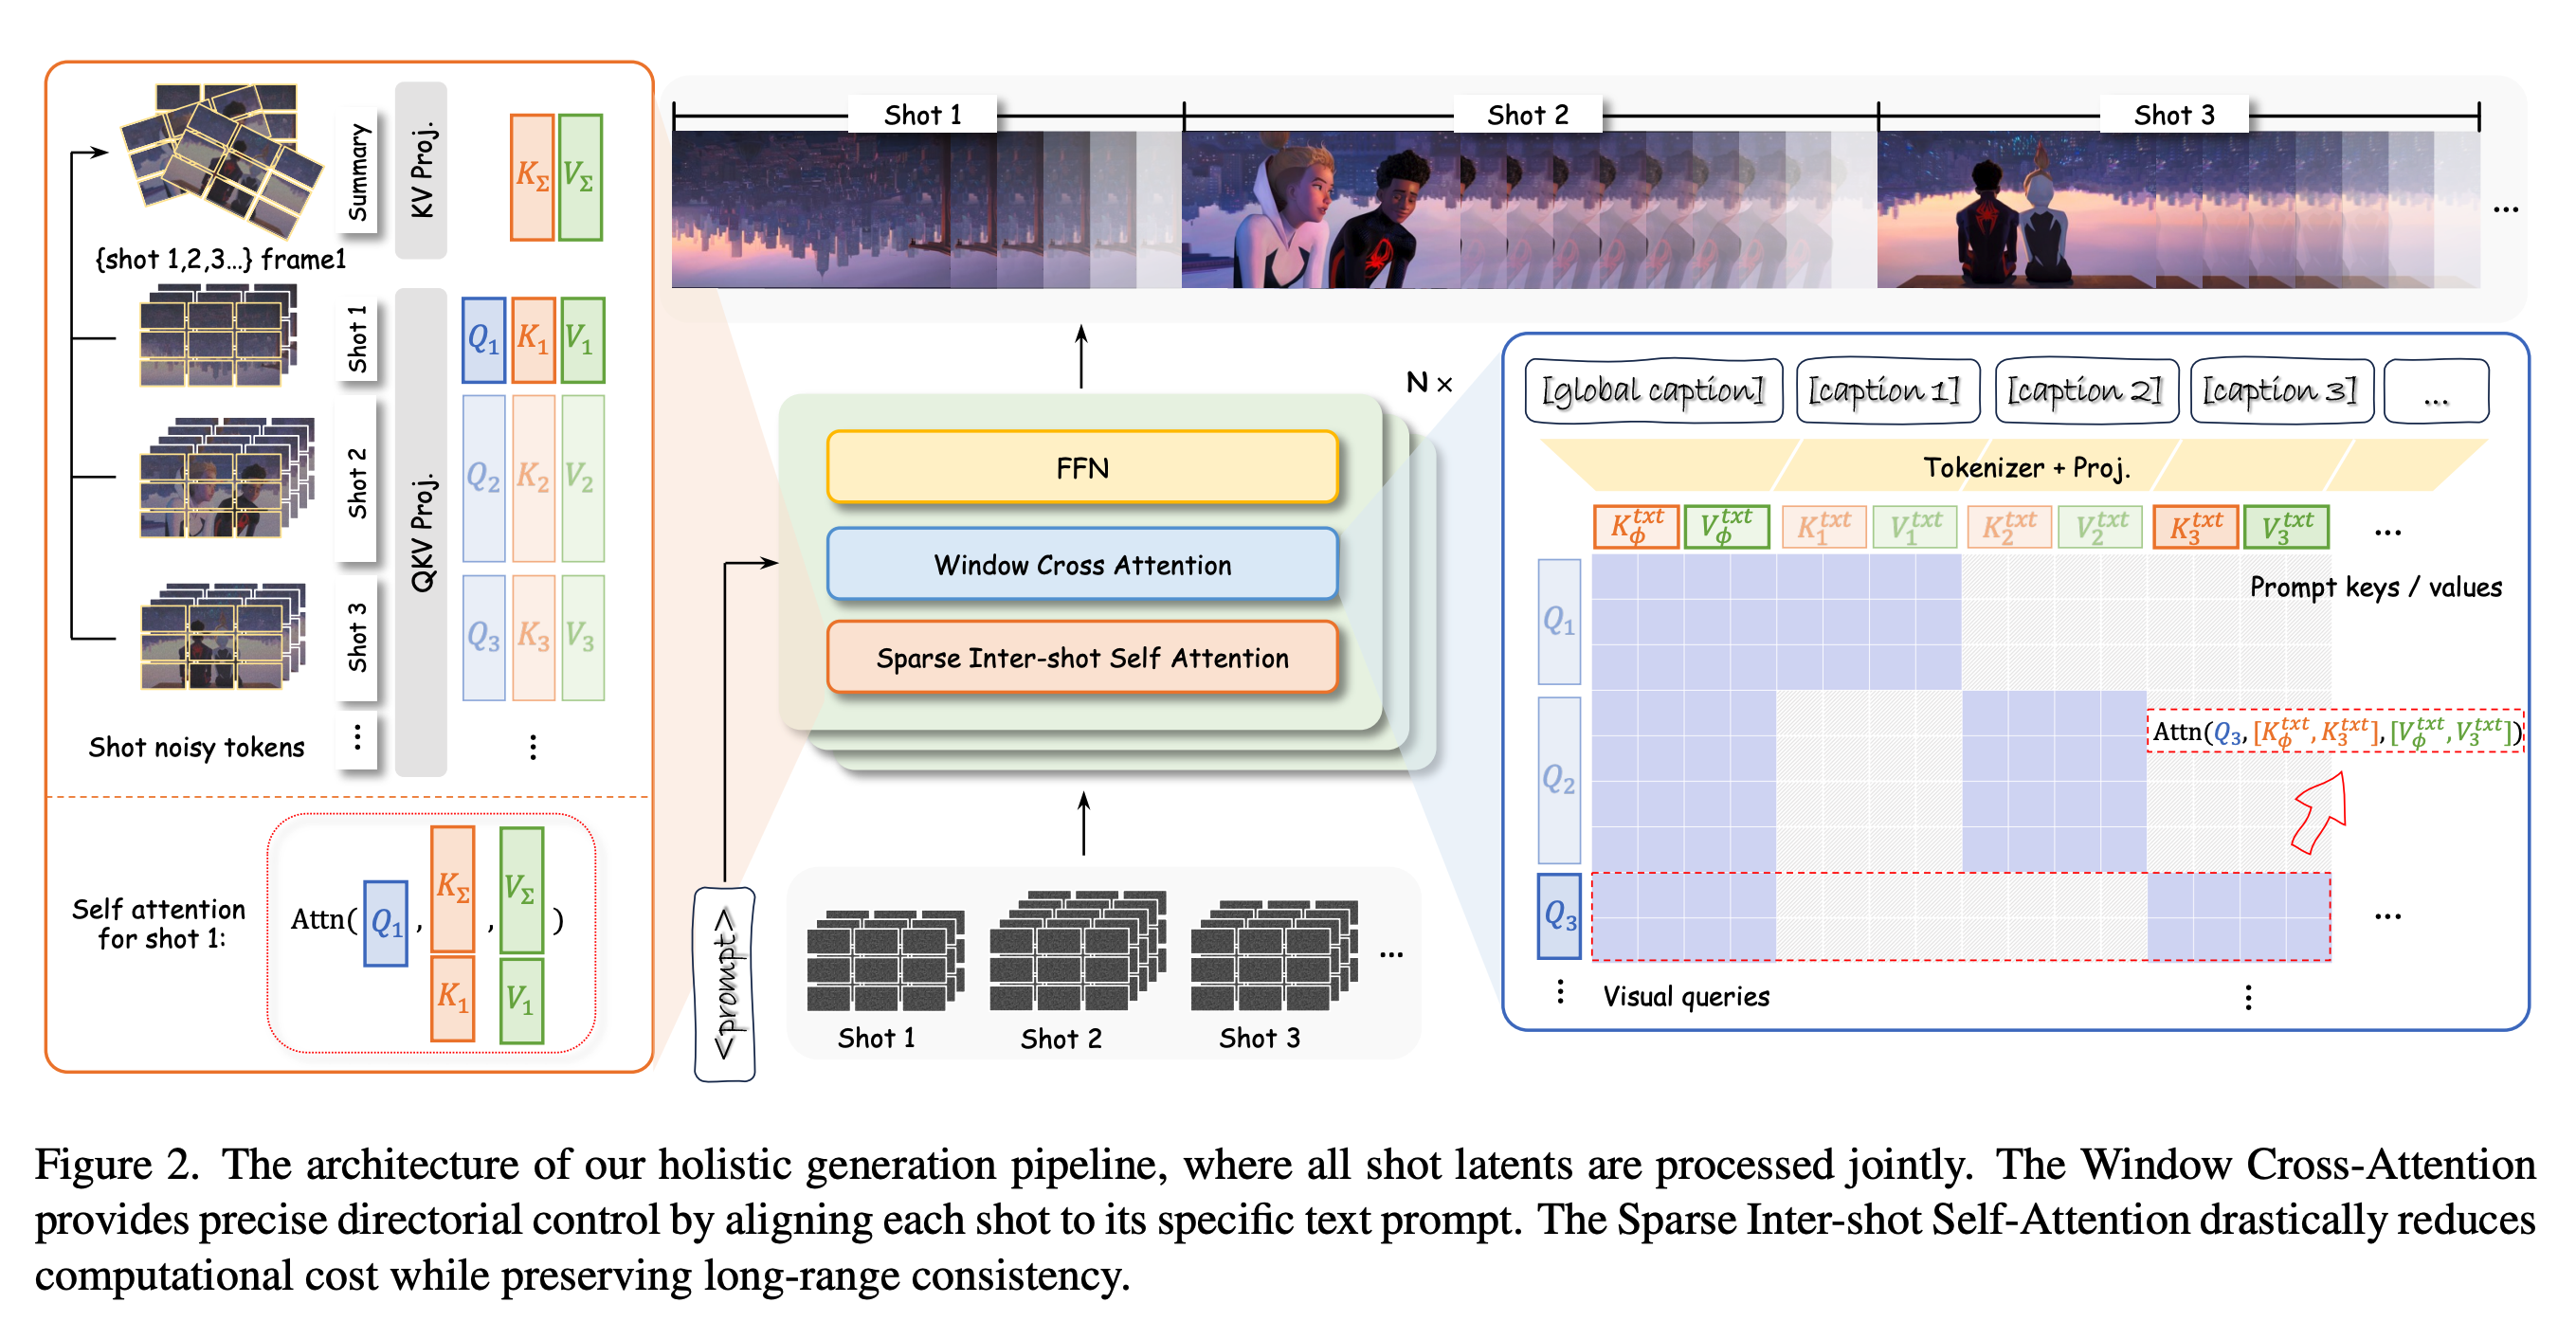
Sparse Inter-Shot Self-Attention

shot 内保持 dense attention;跨 shot 只用代表 / summary tokens 双向通信,降低全序列平方开销。

Window Cross-Attention 继续解决 per-shot prompt alignment,但不是相对前三页最主要的新贡献。
Trade-off:仍需完整脚本、离线联合生成;稀疏 summary 可能漏掉细粒度远程状态。
HoloCine architecture

Beyond generation structure

Joint 路线正走向导演接口

ShotDirectorCVPR 2026
🎥

Camera grammar

cut-in / cut-out / shot-reverse-shot / multi-angle + 6-DoF camera。

🧭

Planner → trajectory

VLM planner 自动产生全局对齐的 camera trajectories,连接意图与 renderer。

MAVINarXiv
🔊

音视频与身份绑定

按镜头边界路由画面和声音,并绑定人物外观、声纹与角色 ID。

趋势判断:仅再发明一种 mask / RoPE 的增量空间变小;价值向 camera、audio、reference 与 planner–renderer 对齐迁移。

PART II

Shot-Level Autoregressive

每次 diffusion sampling 生成一个完整 shot

History shotsfixed visual evidence
→
Select / compressframes · entities · tokens
→
Denoise shotᵢwithin-shot bidirectional
→
Write memoryappend / update
vs. holistic
过去已固定,未来不能反向修正。
vs. causal
shot 内仍可使用完整双向 DiT。
核心风险
memory drift 与 exposure bias。

Memory evolution

从 next-shot context,到可验证记忆

2025.08
Next-shot 起点
Cut2NextarXiv前序上下文 + 剪辑关系
2025.12.08
全历史、紧凑检索
OneStoryCVPR 2026caption-guided frame selection
2025.12
Memory 专门化
FilmWeaverAAAI 2026Shot Cache + Temporal Cache
StoryMemarXiv动态 keyframe memory
2026.05
Entity-aware memory
EM-VidarXiventity-indexed latent patches
2026.06
Memory verification
MementoarXivsubject reconstruction supervision
演进主线:被动视觉条件 → 选择 / 压缩 / 分工 / 更新 → 用辅助任务验证记忆。

Global yet compact history

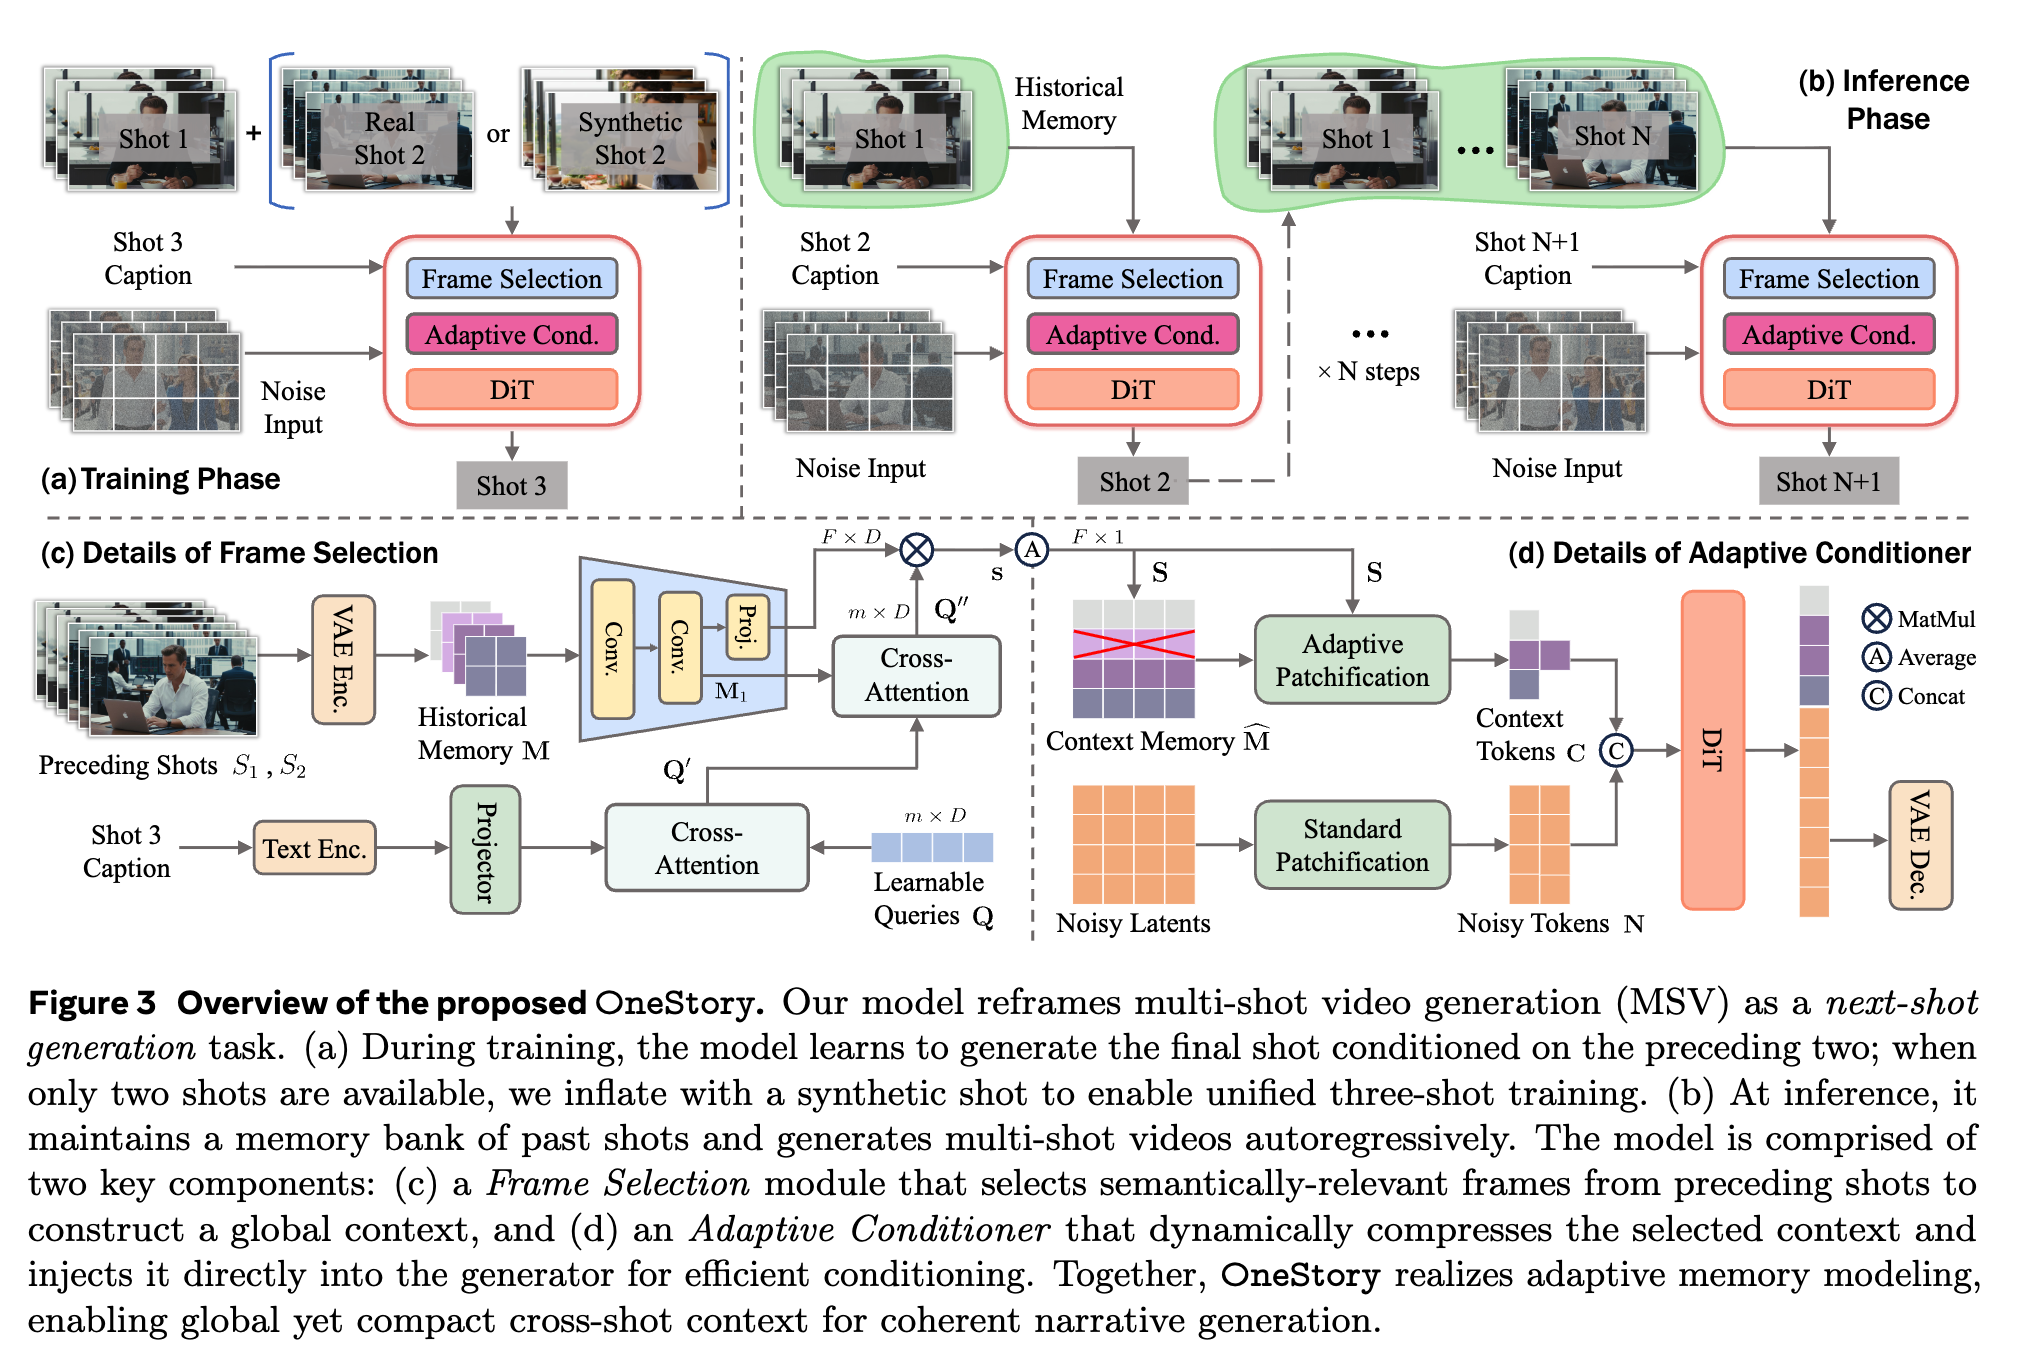
OneStoryCVPR 2026:从全部历史中检索当前 shot 需要的记忆

1 · Frame Selection

当前 caption 作为 query,从所有历史 shots 选择语义相关帧;不等同于只取最近一镜。

2 · Adaptive Conditioner

按重要性 adaptive patchify,把视觉上下文压成 memory tokens,再与当前 noise tokens concat。

all history
→
caption-guided select
→
compact tokens
局限:没有自动 story planner;memory 的正确性取决于已生成历史。
OneStory framework

Dual-level cache

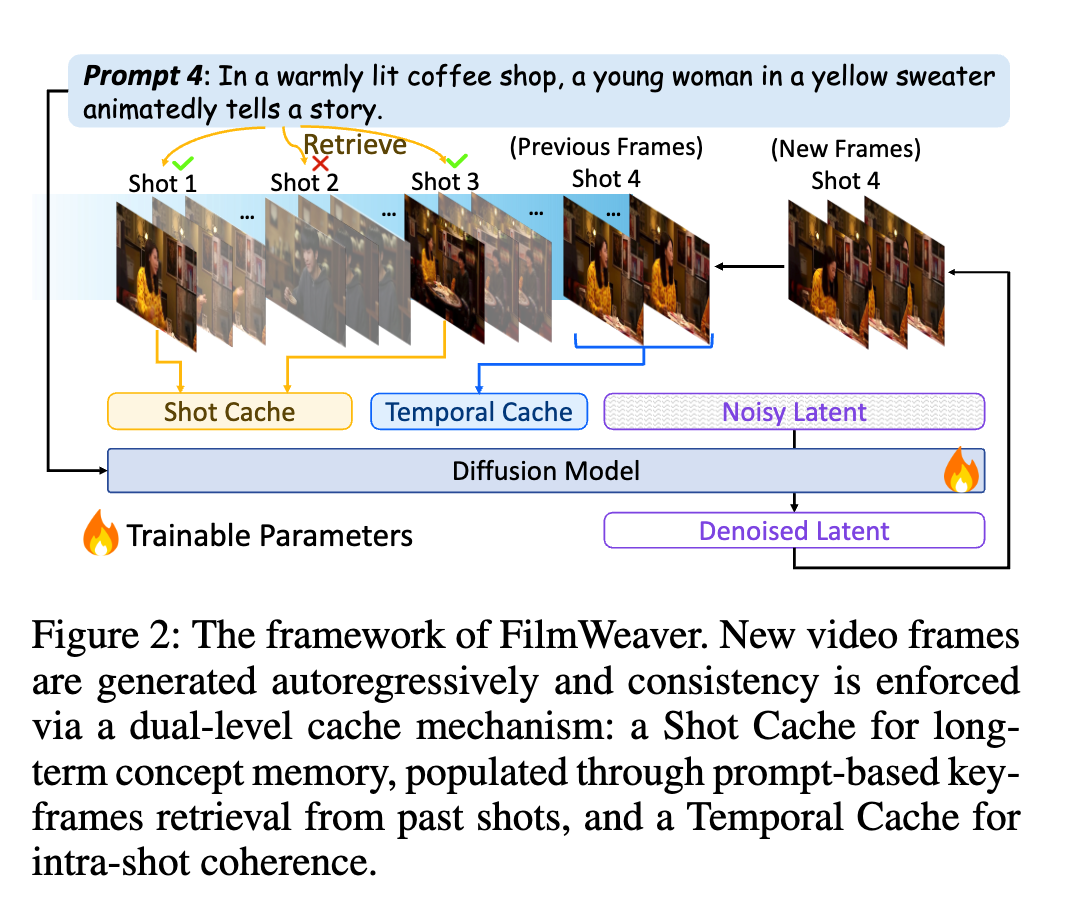
FilmWeaverAAAI 2026:跨镜头身份与镜头内动作,分开记

Shot Cache
Top-K keyframes from old shots
identity · background
+
Temporal Cache
recent current-shot frames
motion · extension

一个模型,四种模式

T2V · new shot · shot extension · full-cache extension。

关键分工:Shot Cache 负责长程概念召回;Temporal Cache 负责镜头内部连续。
不要过度解读:“arbitrary length”是架构可扩展性,不等于无限 rollout 无漂移。
FilmWeaver dual cache

Reconstruction-supervised memory

MementoarXiv:好的 memory 应该能够重建主体

History bankgenerated visual evidence
→
Dual-query retrievalidentity · continuity
→
Next-shot generatortarget caption + memory
Identity evidence
→
Subject reconstruction
→
Auxiliary loss ✓
核心变化:next-shot generation 与 memory-based subject reconstruction 联合训练。

Long-term query

找身份最稳定、跨距最远的 evidence。

Short-term query

找动作、姿态与局部 continuity cues。

开放问题:重建监督能否扩展到道具状态、空间关系和事件结果?

Memory becomes state

Shot-AR:从“存哪些帧”走向可写、可检索、可验证的状态

arXiv

相邻镜头关系与 next-shot reference。

previous → next
arXiv

动态选择 keyframes;latent concat + negative RoPE。

frames → compact context
arXiv

只存实体相关 latent patches,以 entity index 检索并预算更新。

entity → sparse patches
HYBRID

具有 context-causal 或 conditional extension 的边界能力。

joint model + causal mode
趋势:memory 的组织单位从 frame 变成 entity / state;更新策略从无限追加变成固定预算与辅助验证。

PART III

Causal Streaming

按 frame / chunk 因果 rollout,边生成、边输出

Promptᵢcan arrive at runtime
→
Causal chunkᵢcannot revise the past
→
Bounded stateKV / latent / anchor frames
↻
在线性
逐镜头接收 prompt,尽早输出。
历史复用
使用可复用或有界的 cache / state。
严格边界
一次生成完整 shot 还不够。

One-slide prehistory

Multi-shot streaming 建立在 causal video distillation 之上

CausVidblock-causal architecture
→
Self Forcing / AAPTtrain on self-generated history
→
Rolling Forcing / LongLivelong-horizon rollout
→
Causal Forcingfew-step causal distillation

有关 forcing 系列的公式、训练阶段与技术演进,
详见下面的组内分享。

Forcing 系列|AR 视频蒸馏技术演进 ↗

Teacher → causal student

ShotStreamarXiv · 2026.03:双向 next-shot teacher 蒸馏成实时 causal student

① Next-shot teacher

稀疏历史帧 + global / local captions
双向去噪一个完整目标 shot

→

② Teacher → student

DMD 把约 50 步 teacher
蒸馏为 4-step causal student

→

③ Streaming rollout

shot 间逐镜追加
shot 内按 chunk 因果输出

Dual cache

Global

跨镜头稀疏帧

+
Local

当前镜头近期 chunks

→
next chunk

RoPE discontinuity

在 cut 处引入位置相位跳变,避免把跨镜头全局帧误当成当前镜头的连续前帧。

Two-stage self-forcing

先适应当前 shot 内自己的 chunk 历史,再适应由自己生成的历史 shots。

核心思想:先用双向模型学会“下一个镜头应当长什么样”,再把这项能力迁移到可实时输出的 causal rollout。

Native causal prior

CausalCinearXiv · 2026.05:先学 multi-shot causal prior,再做 few-step 实时化

① Native causal prior

真实 multi-shot long video
parallel teacher forcing

→

② Content-aware history

CAMR 从远程 KV 中
检索当前内容真正相关的部分

→

③ Few-step causal student

ODE initialization
→ self-forcing DMD + adversarial

CAMR · Content-Aware Memory Routing

current query
⇢
Top-K remote KV
+
recent local KV
→
causal attention

固定 KV 预算下,远程历史按内容相关性保留;近期历史继续承担局部连续性。

与 ShotStream 的区别:先把生成器本身训练成 native multi-shot causal base,再做实时蒸馏。
不要把速度当作主贡献:不同 backbone 与硬件下的 FPS 不可直接横比;这里关注 causal prior 与历史路由。

Runtime shot switching

LongLive 2.0arXiv · 2026.05:两组参考帧,处理连续镜头切换

Chunk-wise promptingprompt switch 本身定义 scene cut
Gglobal sink
Gglobal sink
Arecent KV
Arecent KV
A → Bcut
S₂shot sink
Brecent KV
B → Ccut
S₃shot sink

有效 KV:global sink ∪ current shot sink ∪ recent sliding-window history。

Global sink

永久保留视频最初的少量帧,提供跨镜头身份锚点。

Shot-level sink

prompt 切换时,将新镜头开头重新绑定为局部锚点;旧历史与 global sink 不重算。

Direct multi-shot AR training

每个 latent chunk 绑定独立文本,在真实 multi-shot 长视频上直接学习 clean-history → noisy-target。

本页只聚焦 multi-shot:核心是可交互的 chunk prompt 与双尺度 sink;NVFP4、并行和异步解码不展开。

PART IV

System / Agent

在视频模型之外,决定怎样拆分、生成、检查与重试

✍️
拆分故事

shots · assets · camera

→
🗂️
管理参考

character · prop · bg

→
🎬
调用生成器

joint · shot-AR · causal

→
🔎
检查与重试

verify · repair · update

阶段 1
预先规划,单向生成。
阶段 2
生成过程中的选择与状态管理。
阶段 3
视觉反馈驱动闭环。

Decision loop evolution

从预先规划,到视觉反馈闭环

2023.09–2024.12
预先规划,单向生成
VideoDirectorGPTCOLM 2024场景、布局与实体计划
DreamFactoryarXiv多智能体脚本与关键帧
ViGoTNeurIPS 2025 Workshopkeyframe-first 单向流水线

成片通常不会反过来修改原计划。

2025.06–2026.01
选择与状态管理
AniMakerSIGGRAPH Asia 2025评价并选择候选片段
VideoMemoryarXiv维护人物、道具与背景参考

决策进入生成过程,但主要是局部选择或外部状态维护。

2026.05–06
视觉反馈驱动闭环
A²RDarXivretrieve–synthesize–refine–update
IAMFlowarXiv异步视觉检查与 identity memory
CoTriSyGenarXiv成片修订未来 prompt 与 memory
GroundShotarXiv重排镜头并验证参考

生成结果直接改变后续策略。

关键分界:画面只是被保存 / 选择,还是会进一步改变后续生成策略?

Plan first, render later

早期起点:LLM 先做导演,再交给视频生成器

GPT-4 story decomposition
↓
scene · layout · entities
↓
consistency grouping
↓
Layout2Vid segments
script agents
↓
character / keyframe design
↓
shot rendering
↓
assemble video
共同局限:计划描述得再细,实际生成结果通常也不会返回规划模块;系统基本按初始方案单向执行。

Training-free keyframe-first pipeline

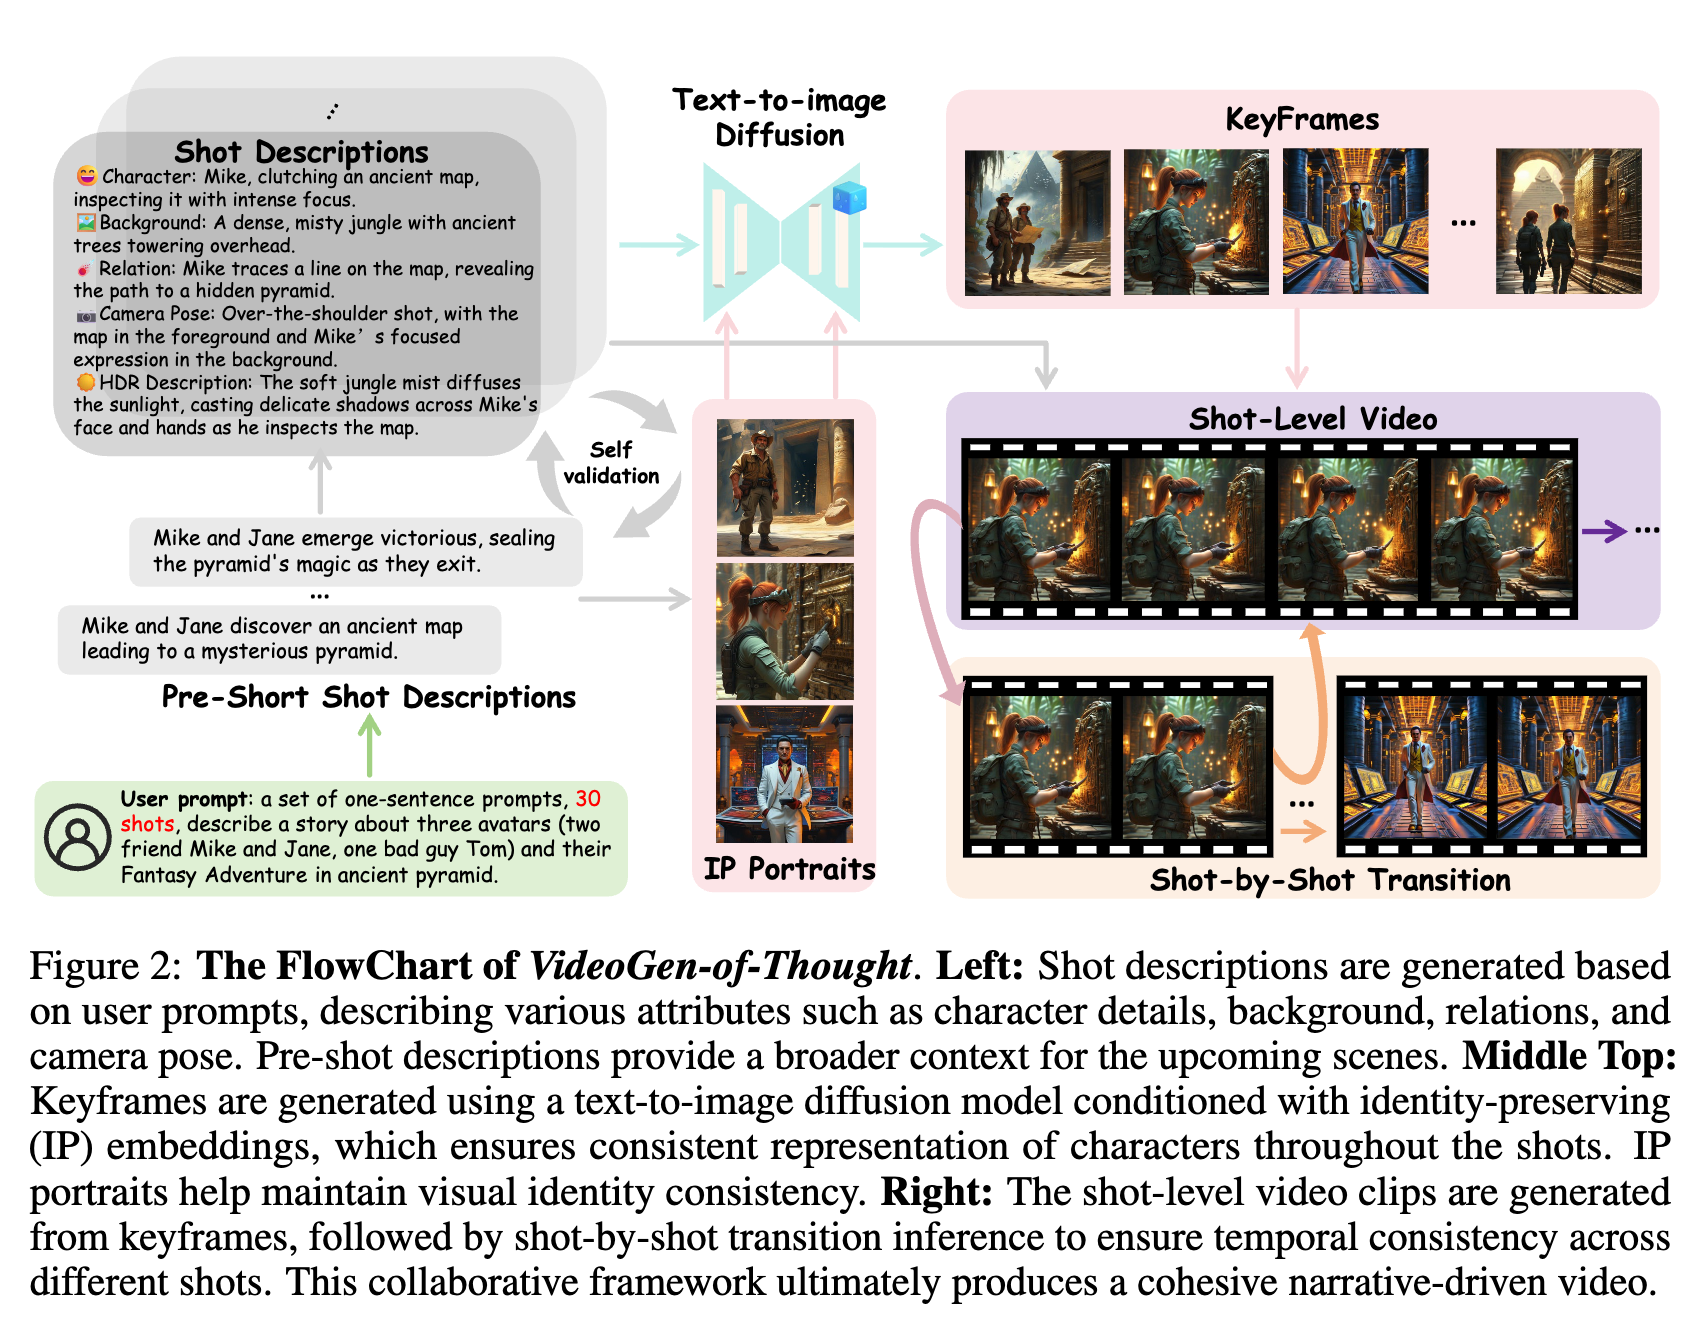
ViGoTNeurIPS 2025 Workshop:先关键帧、后视频的完整系统基线

GPT-4o
5-field per-shot script
↓
Portrait / IP embedding
identity anchor
↓
Per-shot keyframes
text-to-image
↓
DynamiCrafter I2V
shot clips
↓
Adjacent latent transition
批评:身份主要靠显式 reference;长期动作、道具状态与世界状态 memory 较弱。
ViGoT flowchart

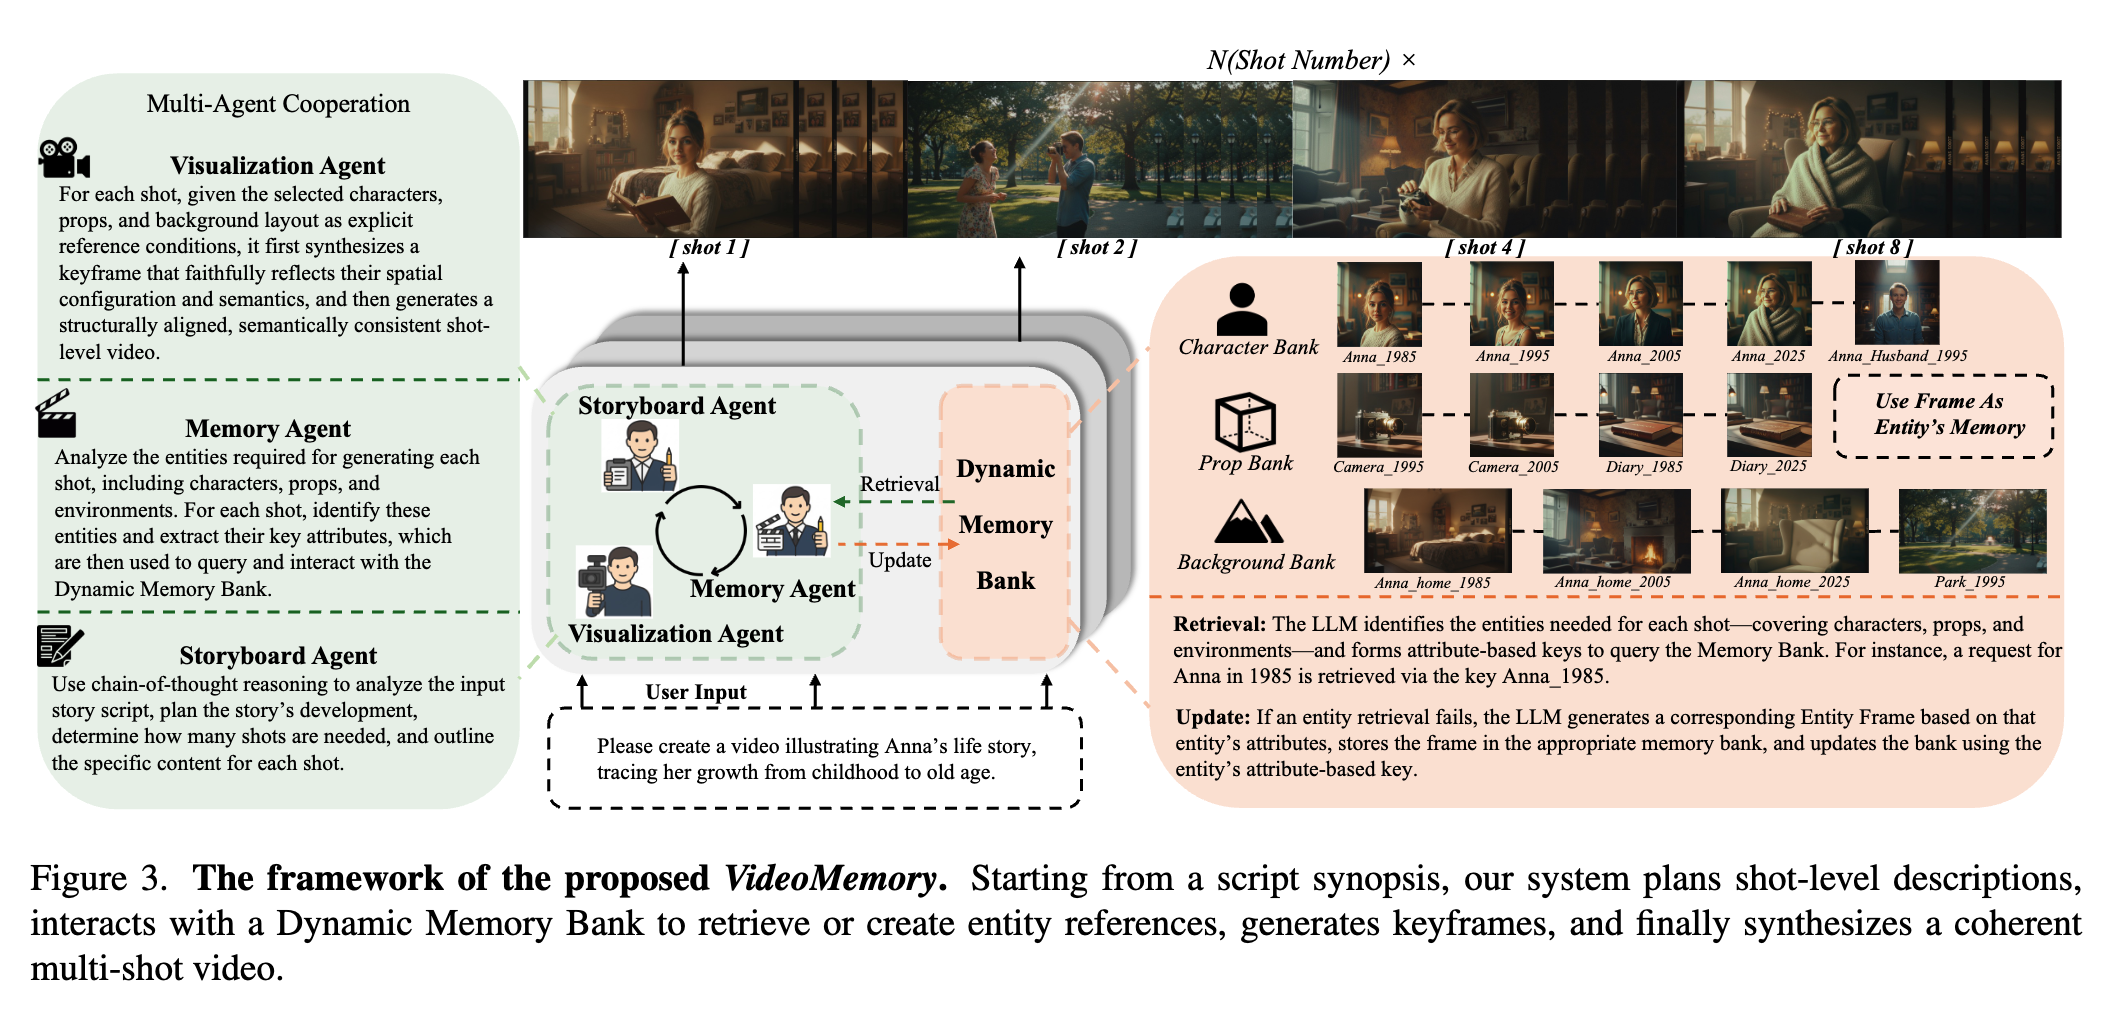
Persistent external assets

VideoMemoryarXiv:人物、道具、背景分别维护

👤
Character bank

identity + age / costume state

🧳
Prop bank

object appearance + attributes

🏞️
Background bank

recurring environments

Storyboard Agent
→
retrieve / create
→
keyframe + I2V
→
update bank
价值:支持远距离实体重现与故事中的状态变化,而不是每镜重新采样外观。
边界:它维护参考信息,但不检查实际成片、诊断错误并触发局部重做,因此还不是视觉反馈闭环。
VideoMemory framework

Generated frames become evidence

GroundShotarXiv · 2026.06:先生成最适合作为参考的 shot

AniMaker

生成候选并由 reviewer 局部评价 / 选择。

SIGGRAPH Asia 2025
VideoMemory

持续维护人物、道具与背景参考,但无成片诊断。

arXiv
A²RD · IAMFlow · CoTriSyGen

生成后检查、更新状态、修正后续输入或触发重做。

arXiv · 2026
2026 的变化:不是更多 agent 角色,而是视觉证据进入决策。

No single SOTA

四条路线的统一 trade-off

维度Holistic jointShot-level ARCausal streamingAgentic system
全局双向协调强弱 / 间接弱 / 间接取决于 planner / repair
任意追加弱强强强
首帧延迟高中低通常高且不稳定
历史成本全上下文memory-dependentbounded cache外部资产 / API dependent
局部修正通常需重做全部从该 shot 起重做后续过去难修改,可继续 rollout可重做指定 shot 并更新后续
主要风险context scalingmemory drift / exposure biascausal error accumulationcost / verifier bias / mismatch

没有单一 SOTA:任务接口决定合理架构。

Status in 2026.07

有 benchmark 尝试,但尚无统一标准

目前仍占主流:各论文自建测试

ShotAdapter48 prompts · 2/3/4 shots · same/different BG
FilmWeaver20 Gemini-generated five-shot stories
ShotStream / CausalCine各自 100-prompt multi-shot test
VideoMemory54 cases · 4/8/12 shots · entity recurrence
prompt、shot 数、reference、分辨率、evaluator 与硬件均不同,数字不能直接组成排行榜。

MSVBench arXiv

hierarchical scripts + references;20 methods。偏离线综合评测。

EntityBench arXiv

140 episodes · 2,491 shots · up to 50;长程 entity recurrence。

GroundBench arXiv

受控难度下诊断人物、物体与场景一致性。

MuSS arXiv

multi-shot subject-to-video;输入条件更专门。

MSAVBench arXiv

multi-shot audio-video;不能直接覆盖纯视频、在线交互与 agent 系统的全部设置。

结论:不是“没有 benchmark”,而是刚开始成形,尚未成为四条路线共同复用的事实标准。

Takeaways & open questions

从“共享像素历史”,走向共享世界状态

01

架构的边界在哪?

什么时候应该用 holistic 作为全局 quality ceiling,什么时候用 causal rollout,再周期性 repair?

architecture
02

Memory 应该存什么?

帧、latent patch、实体资产,还是可更新的 world state?怎样验证道具与事件状态而不只验证人物外观?

representation
03

闭环系统怎样公平比较?

如果允许不同数量的候选、API 调用与重试,应该怎样把质量、延迟和成本合成可解释的评测?

evaluation

2025:让多个 shots 进入同一生成上下文。
2026:在线扩展、管理历史,并让视觉结果进入决策闭环。

S 演讲者视图 · ← → 翻页 · F 全屏 · O 总览 · 虚线术语可悬停