Sora-2 在白板上写出答案,功劳是谁的?
Sora-2 GSM8K 答对 98.9%;目测几何还赢了 GPT-5(40.2 vs 29.7)。
可是:
- 98.9 读的是音轨里说出的答案,读末帧只有 75.7
- 在 Wan 2.5 上关掉提示词改写器,GSM8K 78.4 → 0
- 答对的题里,过程全对的只有 13.91%
- 26 篇里有 13 篇用了闭源 API,没提 API 自带的改写器(名单)
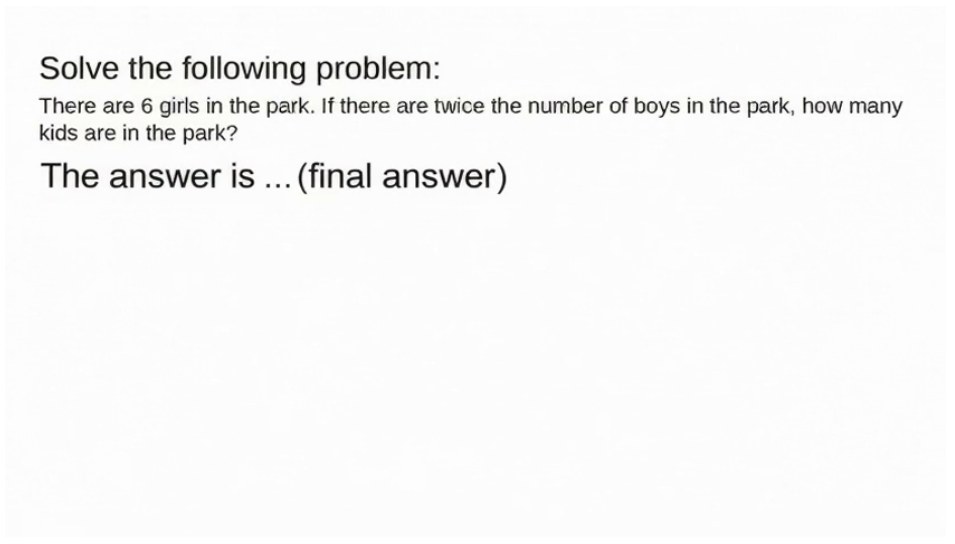
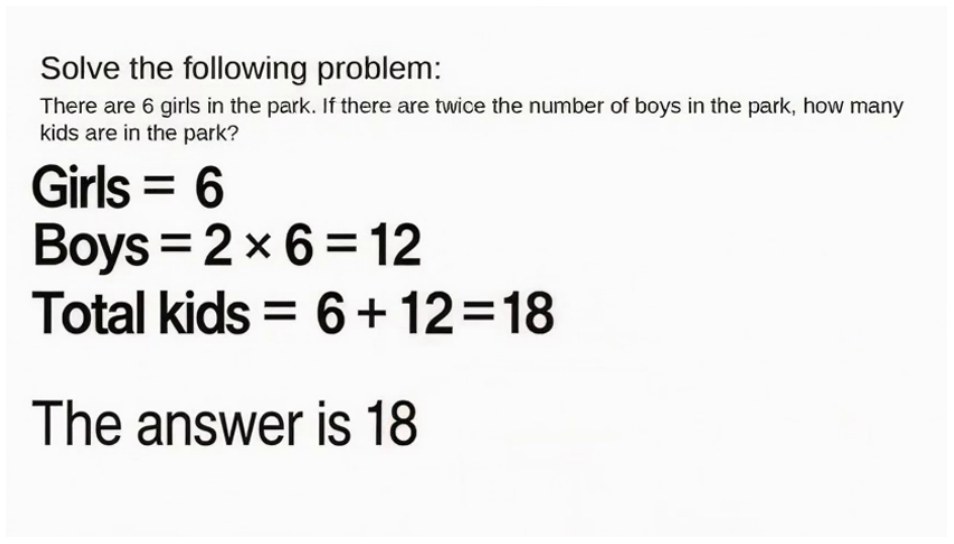
只改提示词、不动权重:两个开源模型分数翻倍
24 类任务、三档难度、595 题;最强的 Sora 2 生成 1 次就对的只有 27.9%。
VideoTPO:每轮生成 2 段视频,GPT-4o 对比两段、写批评、改写提示词,默认 2 轮;模型权重不动。
- Wan2.1 8.40% → 18.15%,HunyuanVideo 4.03% → 10.25%,都高于原提示词生成 5 次挑对的(对比图)
- 例子:23+65=,改写后的提示词没给答案,只加了版式、字体这类要求,就写出了 88
- 提示词是按模型调的:HunyuanVideo 上调好的提示词给 Wan2.1,涨得很少,有的维度还降
和第 4 篇一起看:那边关掉改写器,Wan 2.5 的 GSM8K 从 78.4 掉到 0;这边换上会看视频的改写器,分数翻倍。
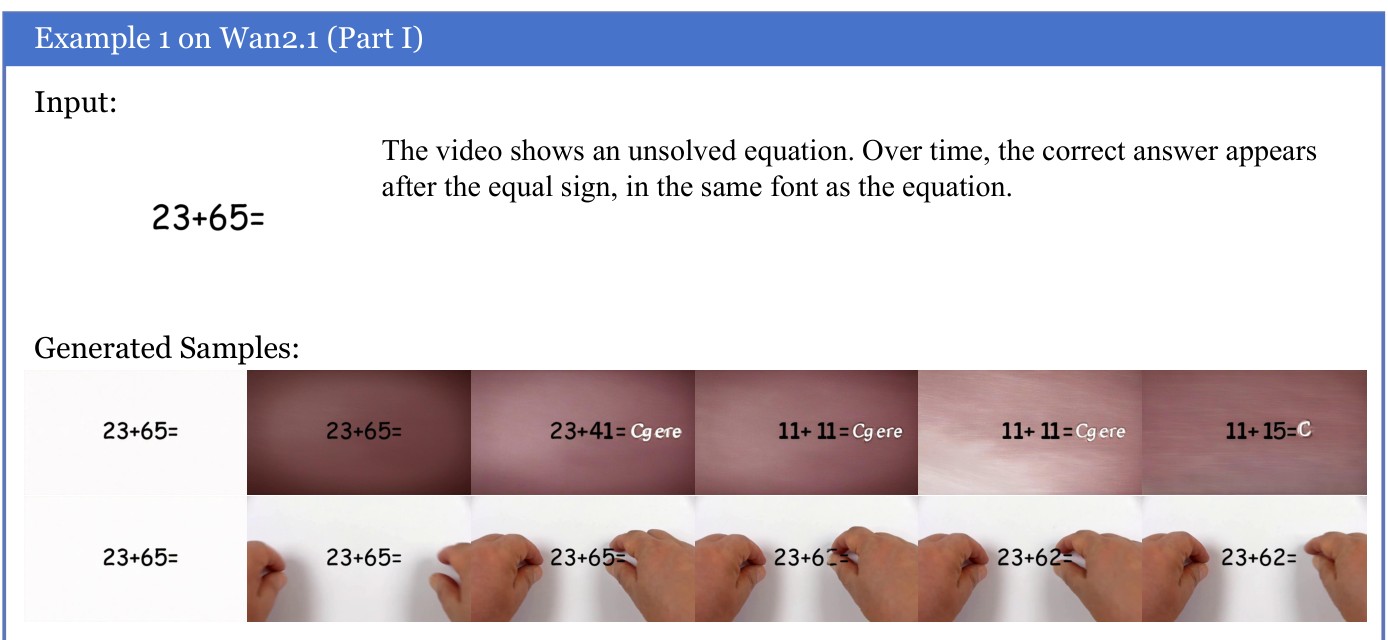 原提示词:两段都没写出答案
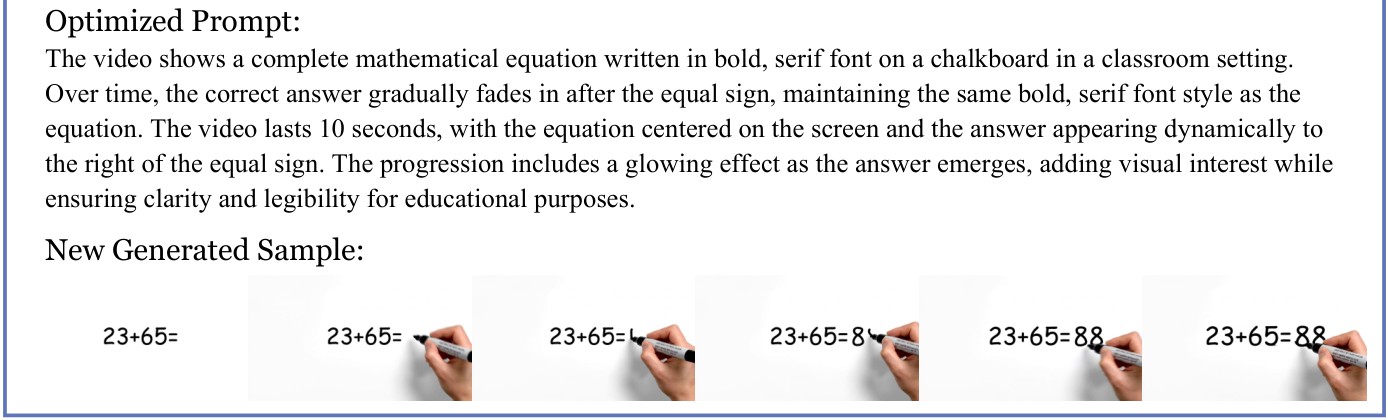 VideoTPO 改写两轮后:写出 88 ✓
只看末帧判分;视频更长,也没解得更好
13 个任务、4 个维度;6 个闭源模型每题生成 5 段(pass@5),判分只看最后一帧。
- 论文的理由:答案都画在末帧上;逐帧评“要大量标注、算力太贵,信号还嘈杂”
- 能用规则就用规则:VLM 裁判会数错网格;和人工判的一致率 97%(一致率)
- Sora-2 结构化解题 72%,物理只有 26.7%,低于 Hailuo-02 和 Vidu-Q2(各维度成绩)
它还试了让模型“想得更久”:同一道数独,Sora-2 生成 4 秒、8 秒都没解对,两版都改了题面上已给的数字。只有两组例子,没有统计。
它也看到了末帧对、过程错,仍只看末帧,第 12 篇 VIPER就从这里下手;更长为什么不等于想得更久,第 14 篇给了答案。
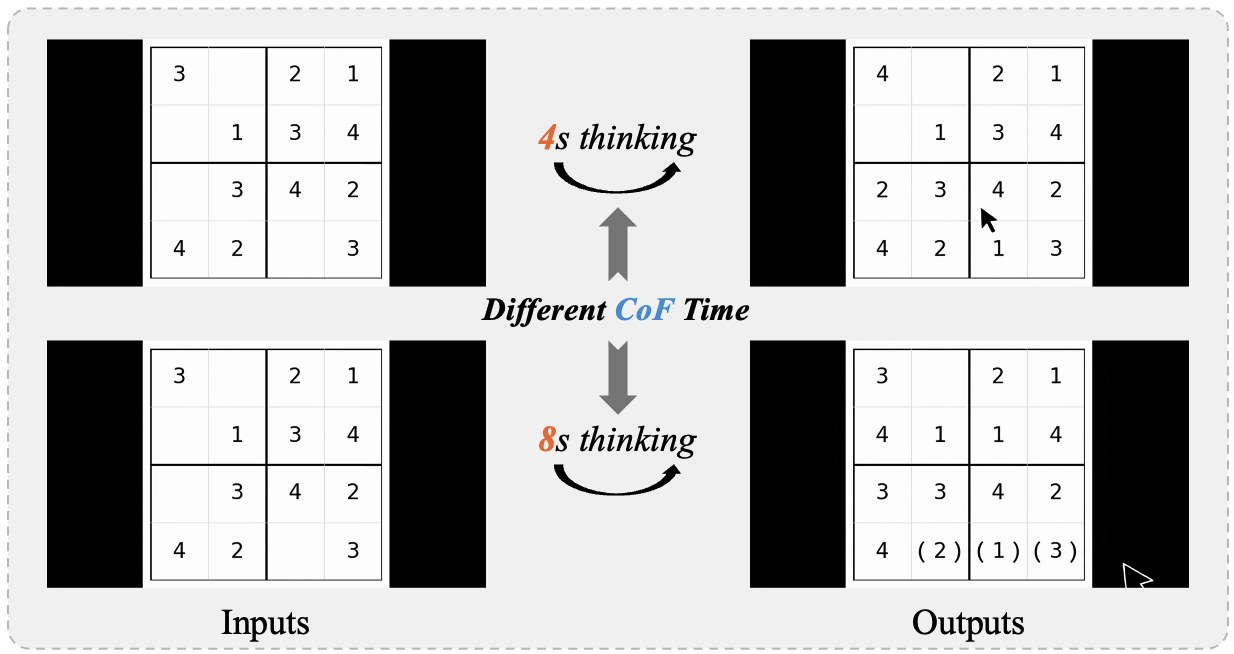 Sora-2 · 同一道数独:生成 4 秒(上)、8 秒(下),都没解对
同一个月,结论相反
| VMEvalKit | MMGR | |
|---|---|---|
| 结论 | 已经能推理:Sora-2 68% | 不能:视频迷宫最好 3.67%,数独 0% |
| 迷宫 | 3×3 | 3×3 到 13×13 |
| 数独 | 只缺一格 | 4×4 和 9×9 |
| 怎么判 | GPT-4o 只看末帧 | 逐帧查像素,条件全满足才算对 |
| 题量 | 每类 15 题,每题生成 1 次 | 10 个任务、1,853 题 |
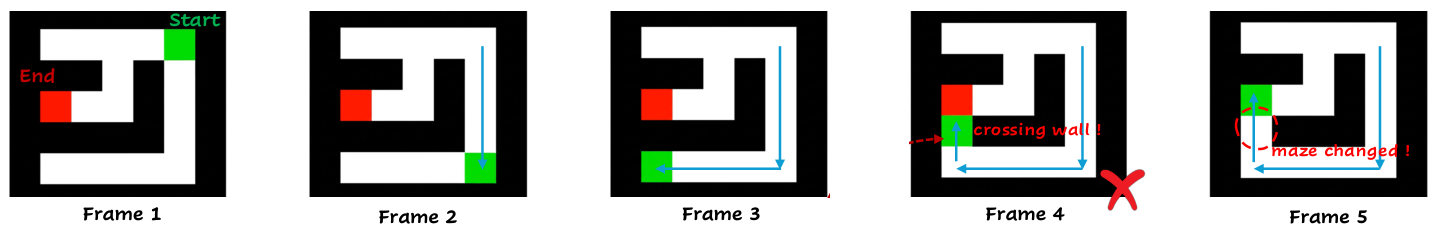 MMGR:Veo-3 到了终点,但第 4 帧穿墙、第 5 帧一段墙没了,判错
同一道题,视频模型和图像模型各怎么做、谁更强
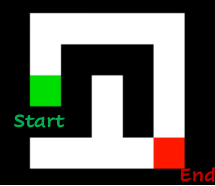
绿块起点,红块终点
“做一段动画:绿块沿白色通道滑到红块,别碰黑墙”
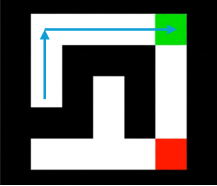
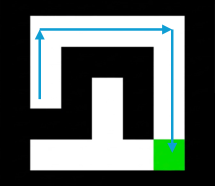
逐帧跟踪绿块
没穿墙、迷宫没变、最后停在红块
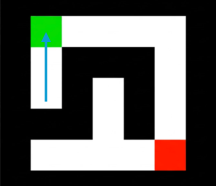
“用一条连续的蓝线,画出从绿块到红块的路线”
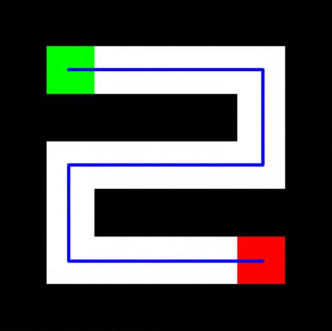
只看这一张
蓝线连通、没碰墙、迷宫没变
图像更强多数题
MMGR 两边都测的 8 个任务,最好的图像模型全部领先:迷宫 9.17 比 3.67,数学 72.69 比 10.61。
视频更强要一步步模拟的题
不规则迷宫:Veo 3 75%,Nano Banana 0%(第 1 篇)。木块滑坡:图像模型画出了两个木块(第 8 篇)。
图像做不了答案是一段运动
MMGR 的物理常识题只测了视频,理由是静态图表示不了随时间展开的因果。
只看结果,成功率是看全程的 2 到 4 倍
红点走错路、墙线都变了,却停在终点:只看末帧会判对。
改成看全程、每一帧都不许违规,同一批视频重判,6 个模型的成功率(%):
怎么判:GPT-5 每秒看 1 帧,对照每道题的细则(例:转椅题)
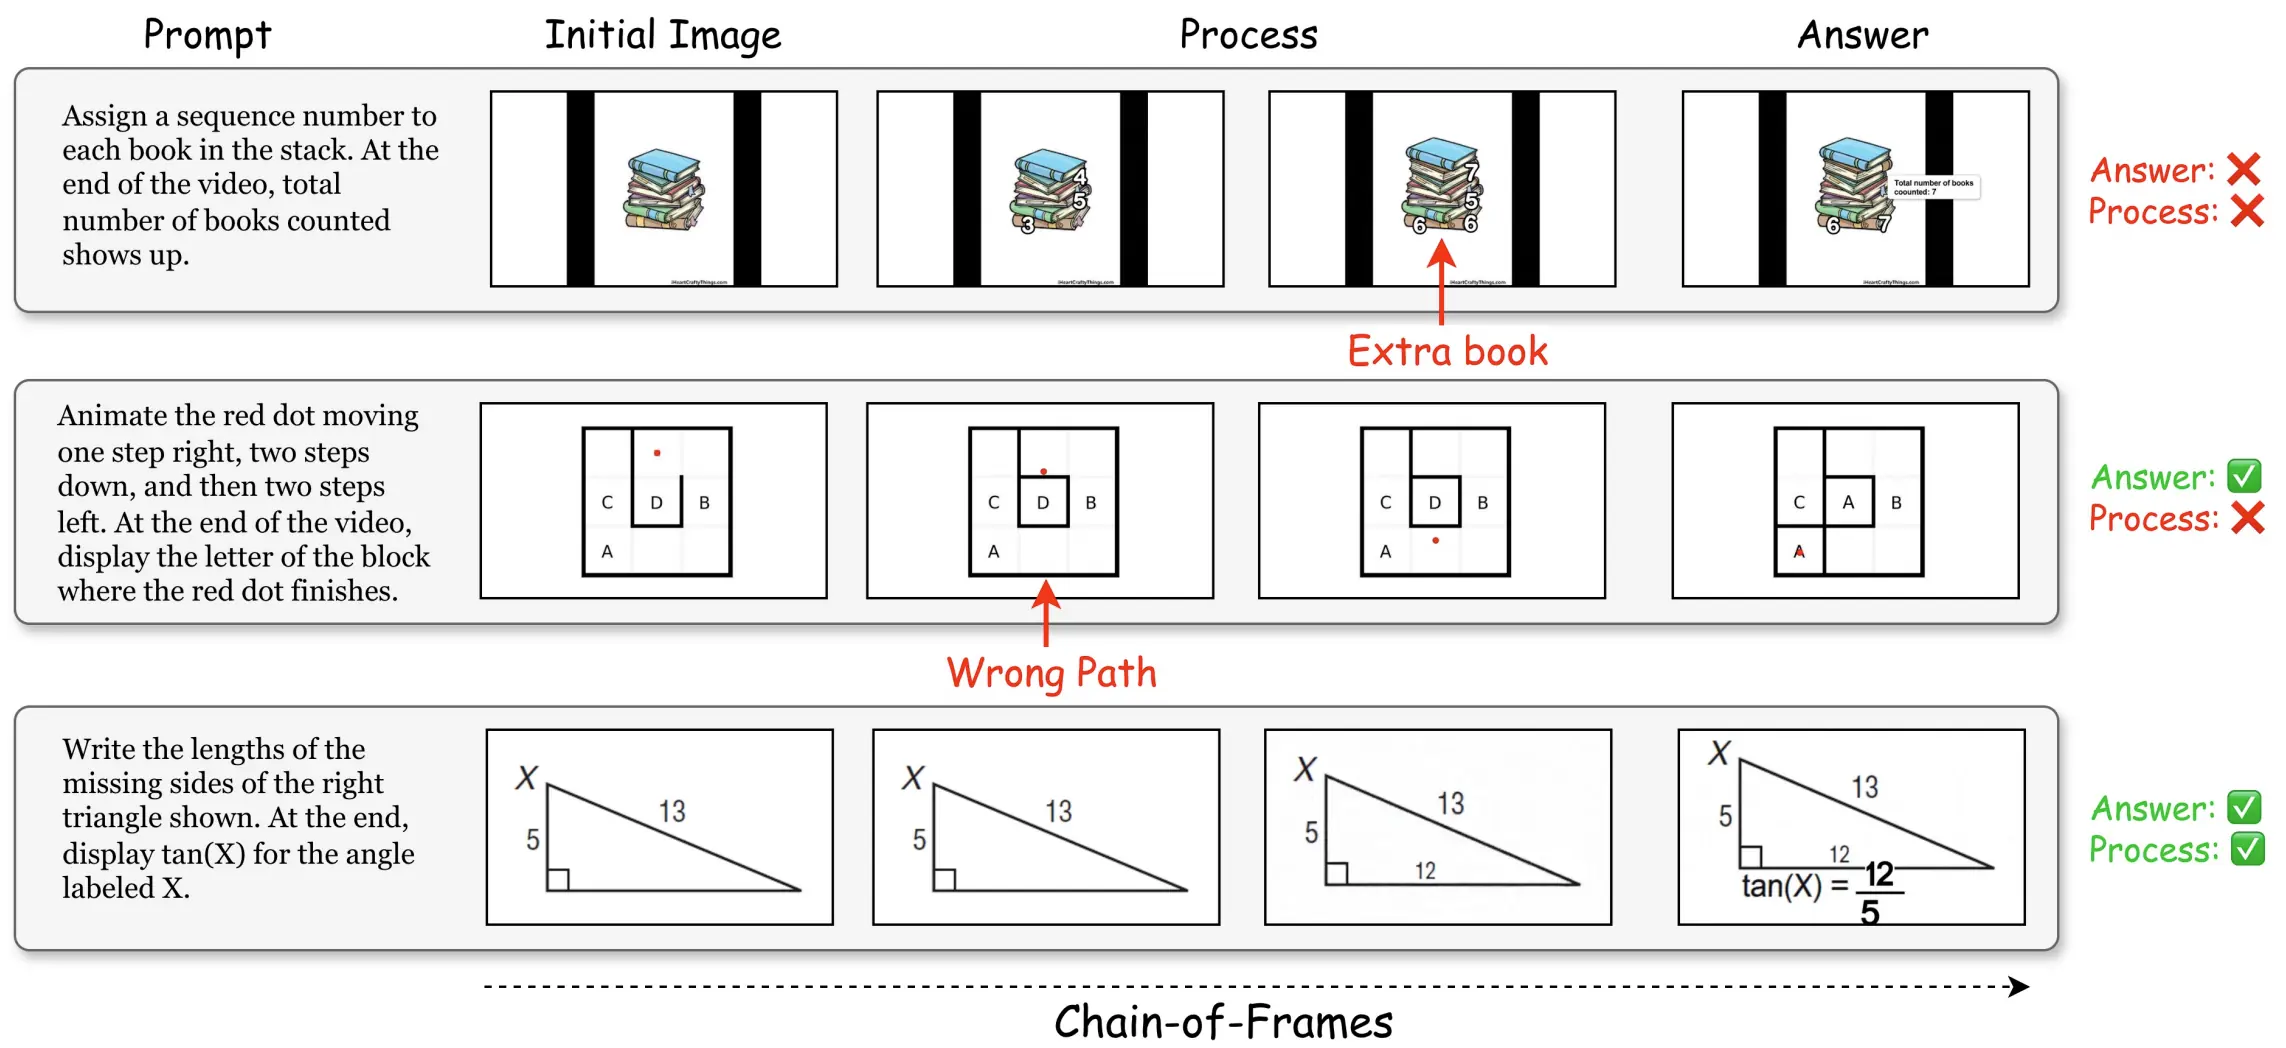
第一个百万级训练集:之前的基准几乎只有测试题
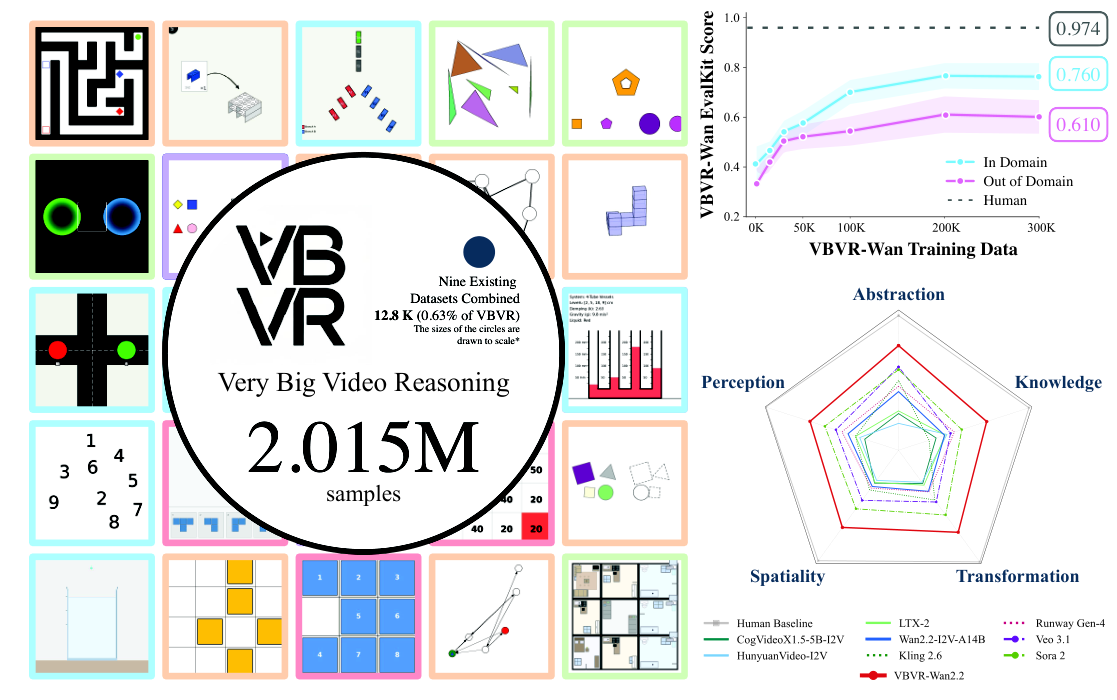
150 个程序生成的抽象任务,按认知心理学分 5 类(感知、变换、空间、抽象、知识);100 个任务各生成 1 万条训练视频,全部规则判分(和人工打分的 Spearman ρ > 0.9)。和前面各篇比(VBVR 表 1):
| 基准(点名字跳到那一页) | 任务 | 训练集(条) | 测试集 |
|---|---|---|---|
| Veo3-ZS第 1 篇 | 69 | 0 | 2,128 |
| MME-CoF第 3 篇 | 12 | 0 | 120 |
| VideoThinkBench第 4 篇 | 24 | 0 | 4,149 |
| TiViBench第 5 篇 | 24 | 0 | 595 |
| Gen-ViRe第 6 篇 | 24 | 0 | 72 |
| VR-Bench第 7 篇 | 5 | 6,336 | 1,538 |
| V-ReasonBench第 8 篇 | 13 | 0 | 326 |
| RULER-Bench第 9 篇 | 40 | 0 | 622 |
| MMGR第 11 篇 | 10 | 0 | 1,853 |
| VBVR | 150 | 1,000,000 | 7,500 |
VBVR 的原话:这个领域“偏评测”,缺大规模训练集和消融协议,没法做可复现的 scaling 研究。
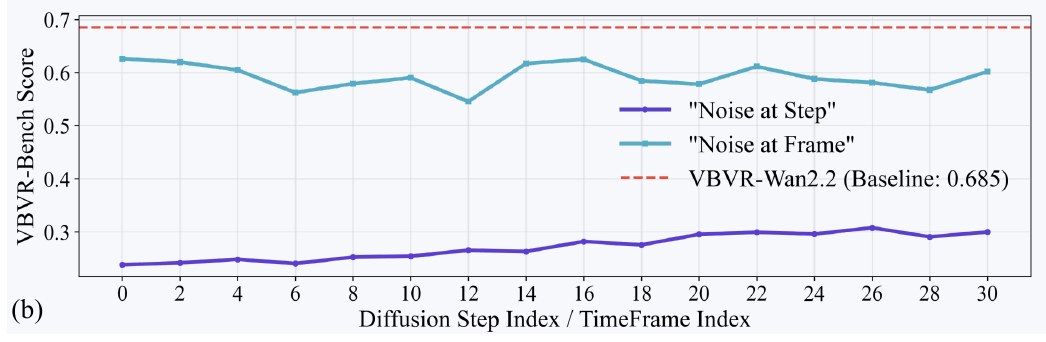
推理沿去噪步展开:某一步加噪,分数掉到 0.3 以下
把每个去噪步预测的成品解码出来看(官方动画):
- 早期几条路同时试(机器人同时探两条路、几个答案叠在一起),中段定下来,后段只修细节
- 某一步给所有帧加噪:0.685 掉到 0.3 以下;每一步都给某一帧加噪:只掉到约 0.6
- 帧也不能太少:约 100 帧降到 17 帧,0.663;只出一帧 0.581
直接反驳第 1 篇的 Chain-of-Frames(示意图)。
换成逐步核对:画质最好的 Kling 推理最差,提示只涨几分
比第 3 篇多了什么:逐步核对
| 第 3 篇 MME-CoF | MME-CoF-Pro | |
|---|---|---|
| 题 | 59 条、12 类 | 303 条、16 类 |
| 怎么判 | Gemini-2.5-Pro 按 5 项通用标准打 0–4 分(指令对齐、画面稳定……) | 每题一份分步细则(平均 4.6 步),Gemini-2.5-Flash 逐步核对 |
| 提示 | 一种写法 | 无提示 / 文字提示 / 画在首帧上 |
同组续作(第 3 篇的作者多数在列)。我的看法:最有用的是把提示做成对照变量;但裁判仍是 VLM,人工验证只有 10 段视频。
画质好,推理不一定好
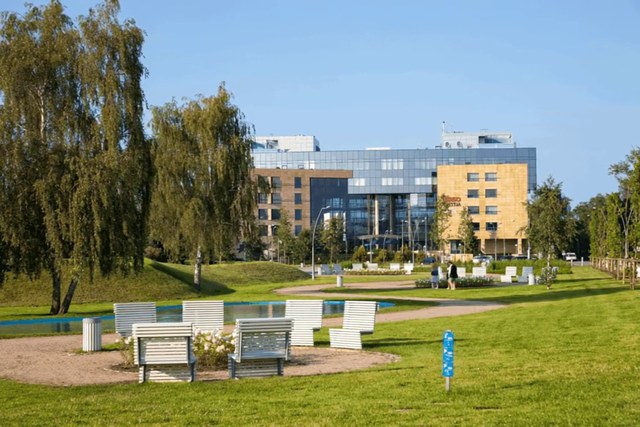
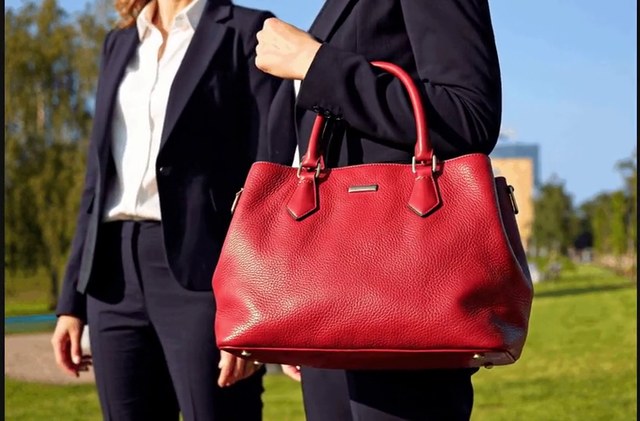
Kling 画质均分最高(65.1),推理分最低(13.8)。下排同一条指令:推近拎包的人、看清包的颜色。
提示:文字只涨几分,箭头会被画进去
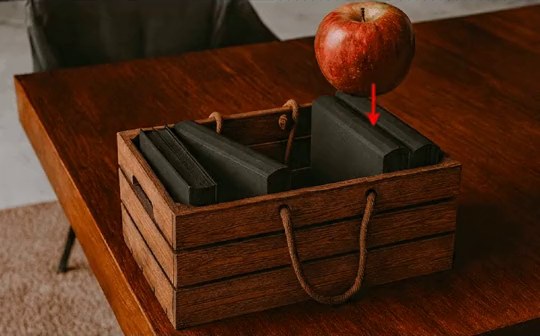
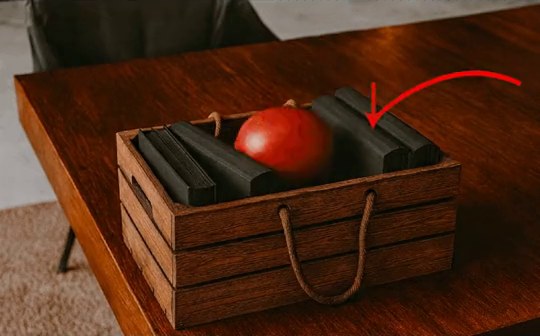
文字提示涨 2.6–7.9 分,Kling 还降 0.4。画在首帧上的红箭头常被当成画面内容一起画出来。
多轮生成:第一轮不到 10%,第二轮起全部失败
把文、图、音、视频一起当上下文喂给模型,看它能不能读懂再生成(6 大类 47 子类)。最难的是多轮交互:模型当老师,用户每轮随机答对或答错,模型要接着生成下一段回应视频。
- Seedance 1.5 / 2.0 第 1 轮不到 10%,第 2、3 轮全部失败,整局 0%
- 让 Seed 2.0 先整理上下文、写好下一段脚本再生成:每轮约 45–60%,整局 26% / 34%(论文图 4)
- 单轮的逻辑推理题也一样:VLM 先读懂再改写指令,Seedance 2.0 从 21.3% 到 49.0%(表 4 和例子)
论文自己的结论:外挂 VLM 只是部分补救,视频模型本身的推理还得靠训练提升。
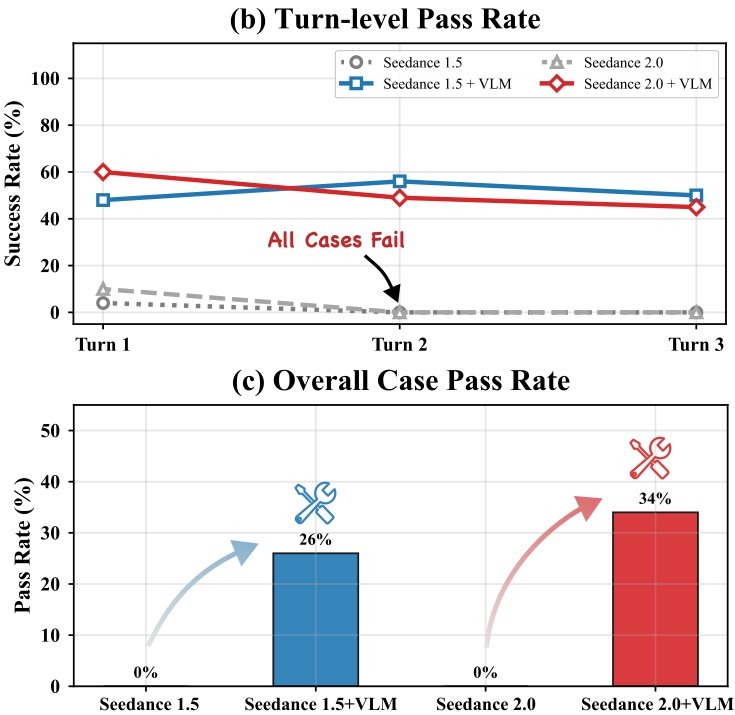 论文图 4:每轮成功率(上)、整局通过率(下)
三条路:多采样挑最好、VLM 写解法、VLM 当老师
① 多采样挑最好Naive Scaling
例子第 16 篇只去噪 5 步就按路线挑种子;第 14 篇把 3 个种子在第 1 步去噪时的特征取平均
短板模型自己画不出的解,挑多少次也挑不出来;生成 5 次挑最好,0.666 → 0.683,时间从 14 秒变 70 秒
② VLM 写解法VLM as Solver
例子第 5 篇的 VideoTPO看视频改写提示词;第 18 篇CollabVR 规划每一步、检查每一段
短板解题路径很难用文字写清;方案写对了,视频模型也常常画不出来。VideoTPO 0.666 → 0.634(57 秒)
③ VLM 当老师VLM as Teacher · 本文
长处每道题现场出专属的检查题,什么任务都能用(换成通用检查题只有 0.712);梯度直接改模型,能超出它原有的能力
0.666 → 0.781,69 秒(成本 × 分数、真实视频)
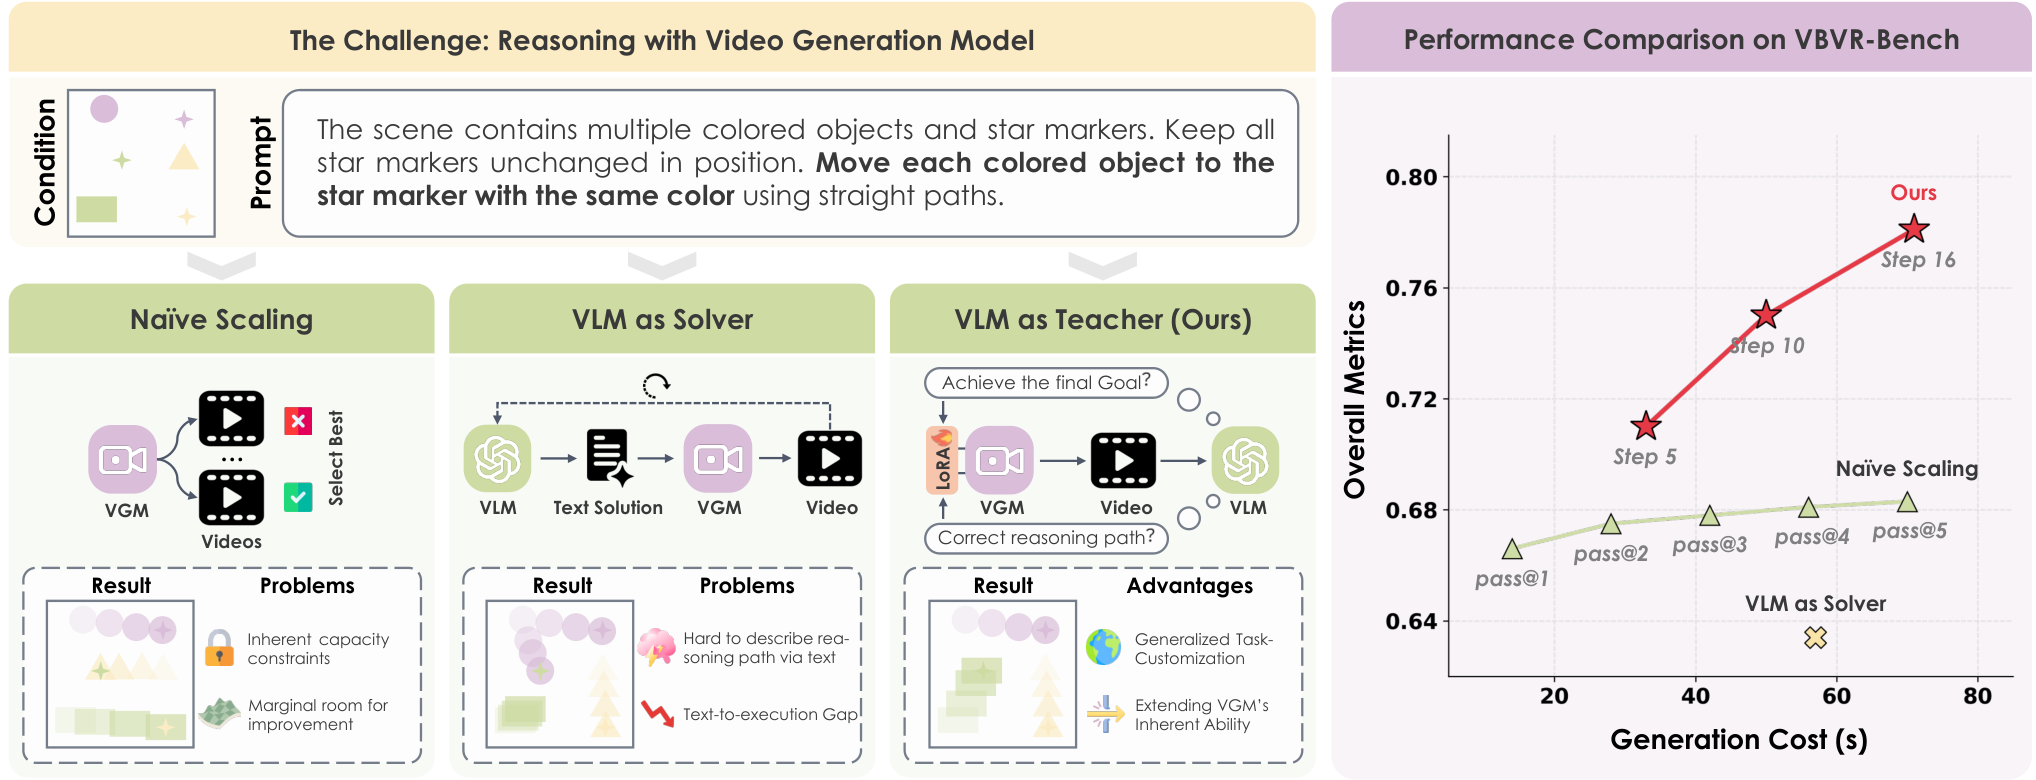 论文图 1 · 右边小图:横轴每题耗时(秒),纵轴 VBVR-Bench 总分
换成自回归:每段等待 37.9 秒 → 0.7 秒,成功率 60% → 34%
前面各篇测的、训的基本都是双向扩散模型(HDR 的原话)。HDR 第一次在自回归(流式)生成上做视频推理:从左往右一段段生成,每段只看已经生成的部分,生成完就能播。
| 双向扩散 | 自回归(流式) | |
|---|---|---|
| 怎么生成 | 一整段一起去噪,每一步所有帧互相看 | 一段接一段,每段只看前面已生成的 |
| 好处 | 去噪结束前,每一帧都还能改;第 14 篇:推理就发生在去噪步之间 | 生成完一段就能播,缓存复用;可以一直往下生成(第 16 篇只能手动从末帧接力);适合机器人实时闭环 |
| 坏处 | 每一步都要算整段:慢,长度固定 | 画出来就定了,前面错了后面只能接着错 |
| 同模型同数据 | 成功率 60.0%;每段等 37.9 秒 | 成功率 34.2%;每段等 0.72 秒(耗时) |
同一个 Wan2.2-5B、同样 1.8 万条视频训练,自回归输得最多的是迷宫:90% → 12%(6 个任务分开看)。典型错法是在岔路口过早选定方向,或者东西画着画着没了(论文图 4 和 11)。
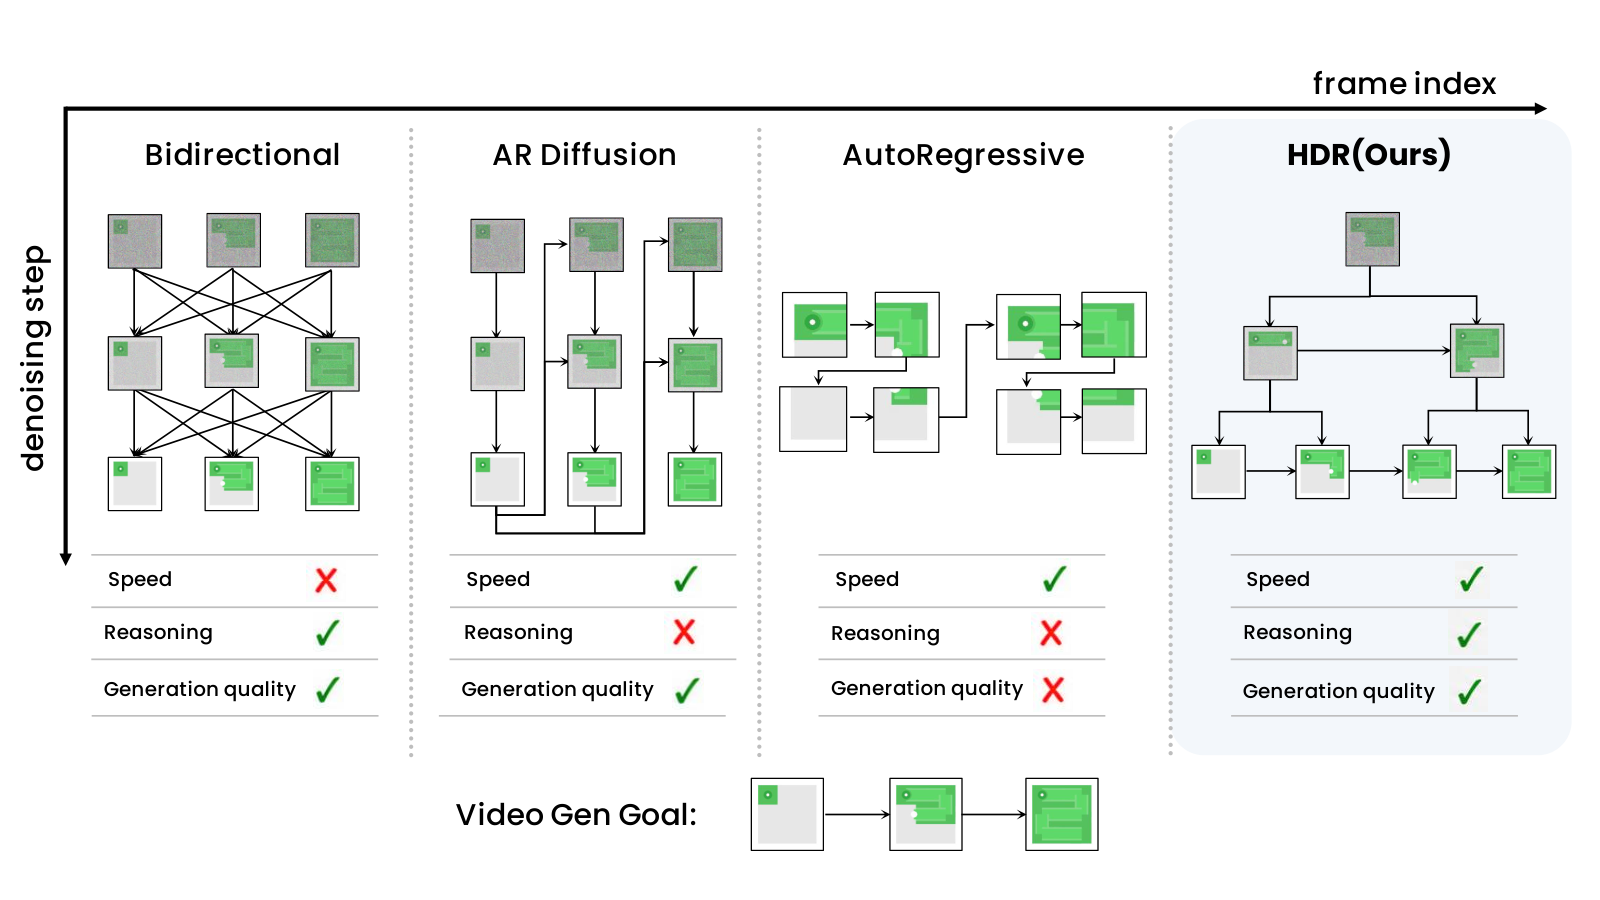 论文图 1:双向、自回归扩散、逐 token 自回归、HDR
先粗后细地去噪:流式也追平双向,60.3% vs 60.0%
做法:把 32 个 latent 排成 6 层的树(1、2、4、8、16、32 个),先生成粗层、再一层层细化,最细一层流式输出;粗层只去噪 5 步、最细层 50 步,故意留着噪声,好同时保留几种走法(结构图)。
- 层数 1 → 6:34.2% → 60.3%;第 4 层那一跳最大(40.1% → 59.2%)
- 去噪只给 1 步:HDR 34.7%,双向 17.8%;训练数据只用 2%:HDR 50.0%,双向 31.2%(两组消融)
- 代价:开始输出前要先预填充 16.2 秒(自回归 2.4 秒);剩下的错多在最后几帧:墙消失、颜色并了(失败例)
60.3% 对 60.0% 是平均出来的:迷宫、推箱子、一笔画仍低于双向,汉诺塔、倒水高于双向(分任务)。
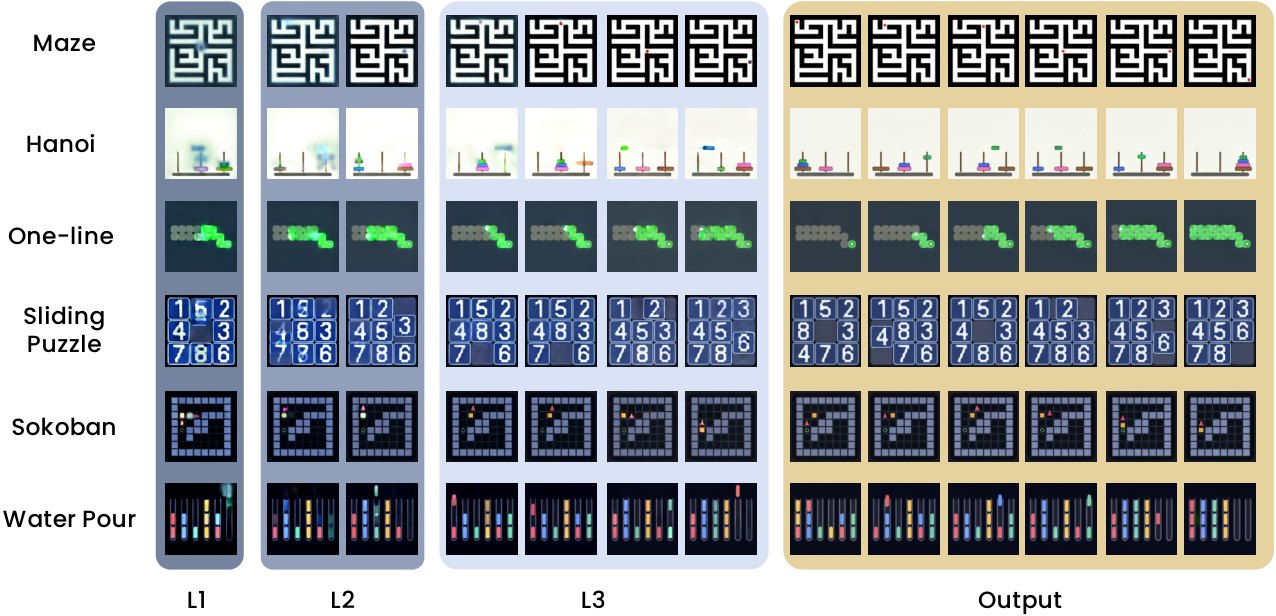 论文图 10:L1 只有 1 个 latent,概括整段;越往下越细,最右是最终输出
同一团队的后续:首帧改写实,Veo 3.1 物理三选一 41.3% → 59.3%
改了三样:首帧、提示词、判分器
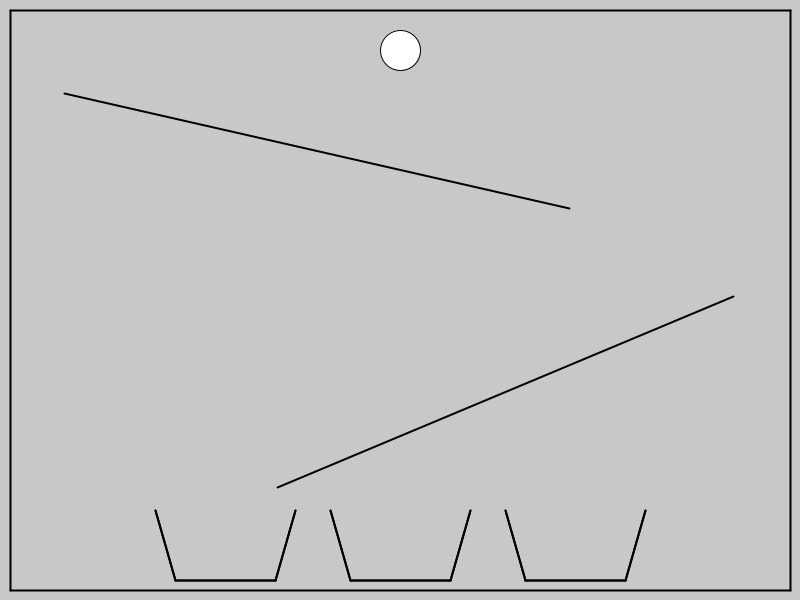
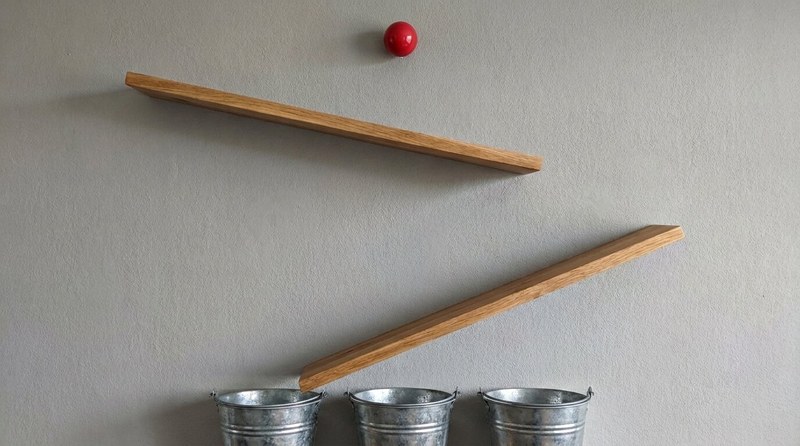
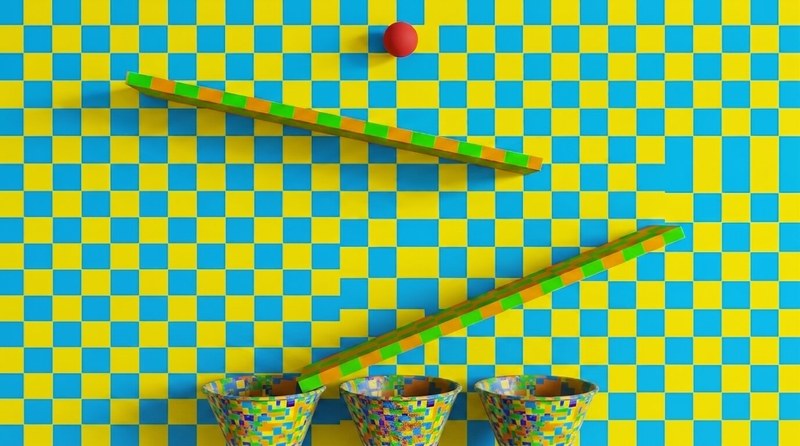
球沿板子滚,落进三个桶之一,瞎猜 33.3%。写实版提示词加了“只有红球动、木板不动”,判分器改成追踪红球。
Veo 3.1:41.3% → 59.3%
同样换了新提示词、只是纹理不写实的对照组 44.0。Omni Flash 56.3 → 67.5,对照组也有 64.5;Wan2.2 各设置都在 32–44。
比多生成几次划算
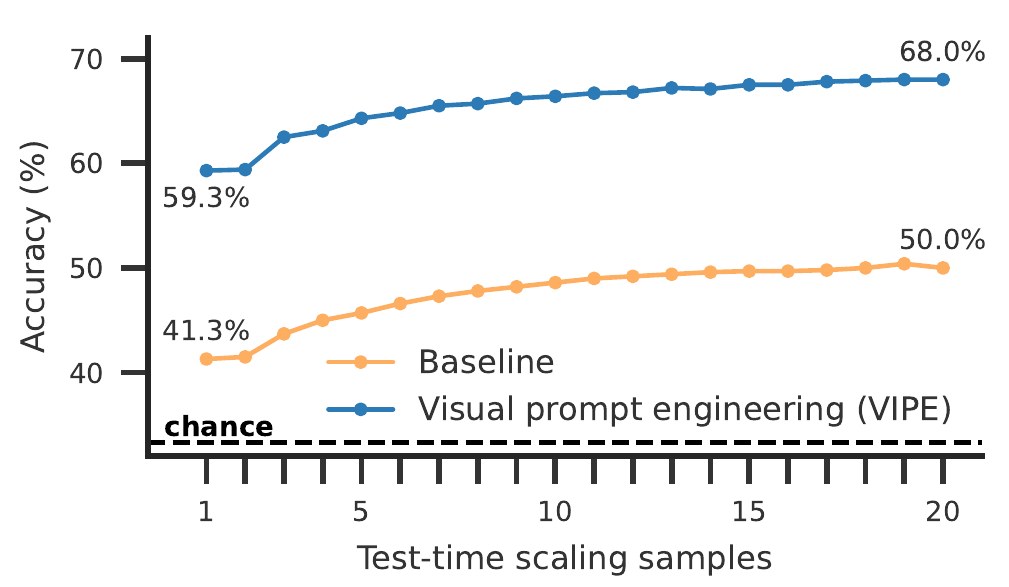
原图生成 20 次投票 50.0%,写实图生成 1 次就 59.3%,再投票到 68.0%。Veo 3.1 一段 8 秒 3.2 美元。
同一团队的后续(和第 1 篇有 6 位作者重叠):第 1 篇原文就说成绩只是能力的“下限”,VIPE 用实验量了出来。换成自动改图,第 1 篇自己的迷宫错误率只降 2.6–18.4%;项目页的单题演示:工厂钢管滑道、迷宫、同色连线、挪车。
写实输入、看全过程:最强的 Seedance 2.0 只全对 14%,人类 97%
题:写实照片,要一步步做
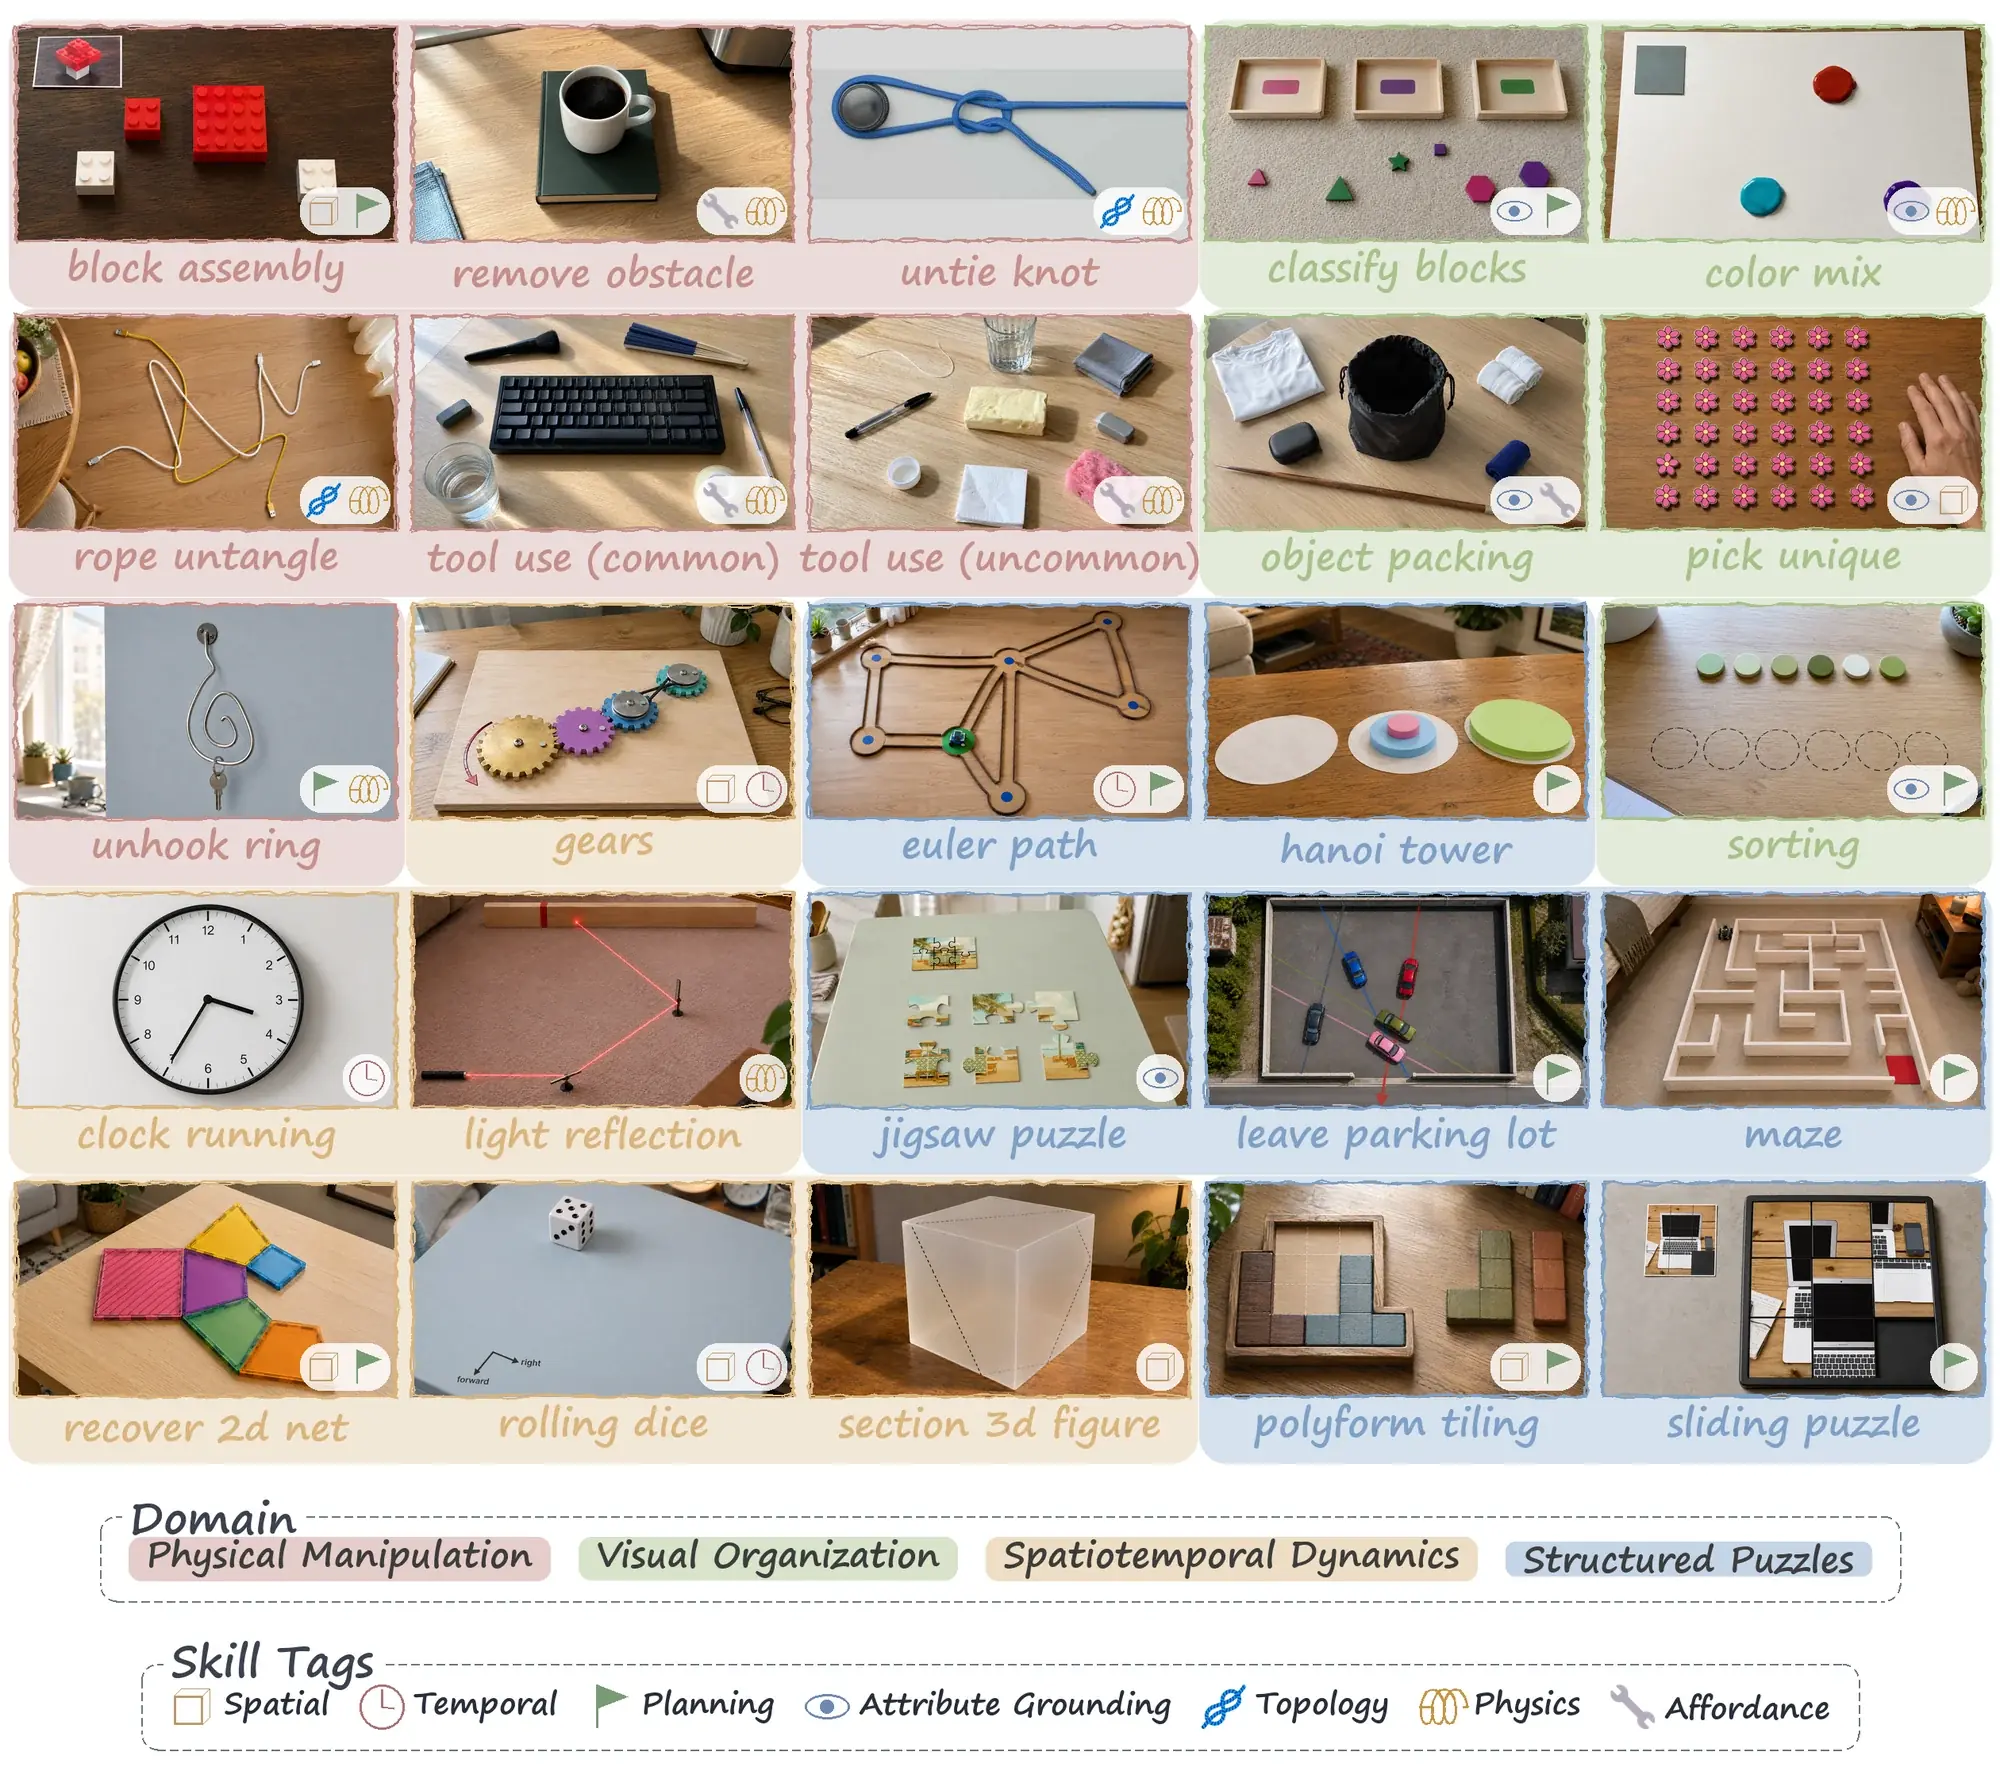
4 个领域(视觉组织、时空动态、结构化谜题、物理操作),每题分易、中、难。只收要走合法中间步骤的题:迷宫、汉诺塔的终点好查,但视频得一步步走到(同一迷宫换成线条画)。
结果:最强的也只全对 14%
VLM 裁判看整段视频:完成度 × 细则分,细则查有没有违规(小车翻墙、一次挪两片)。两项都满分才算严格成功(同一迷宫三个模型的得分)。
合成数据:越像训练题,涨得越多
第 13 篇 VBVR 的模型拿到写实题上:结构相同 +40.5,部分相同 +17.1,不同 +6.2。另外两个 VBVR 模型也是这个顺序,Wan2.1 在“不同”组还掉了 3.6。
去噪中途“错改成对”:702 对里只有 2 对,第 4 步以后一次都没有
第 14 篇说推理沿去噪步展开,还能中途纠错。VGI-Bench 去数这件事有多常见:4 个开源模型(Wan2.2、VBVR-Wan2.2、HunyuanVideo-1.5、LTX-2.3),默认 40 步,把第 1、2、3、4、10、20、40 步预测的成品各解码成视频,相邻两档人工比一比、标一个标签;117 个样本 × 6 段 = 702 对。
第 14 篇:举了几个改对的例子
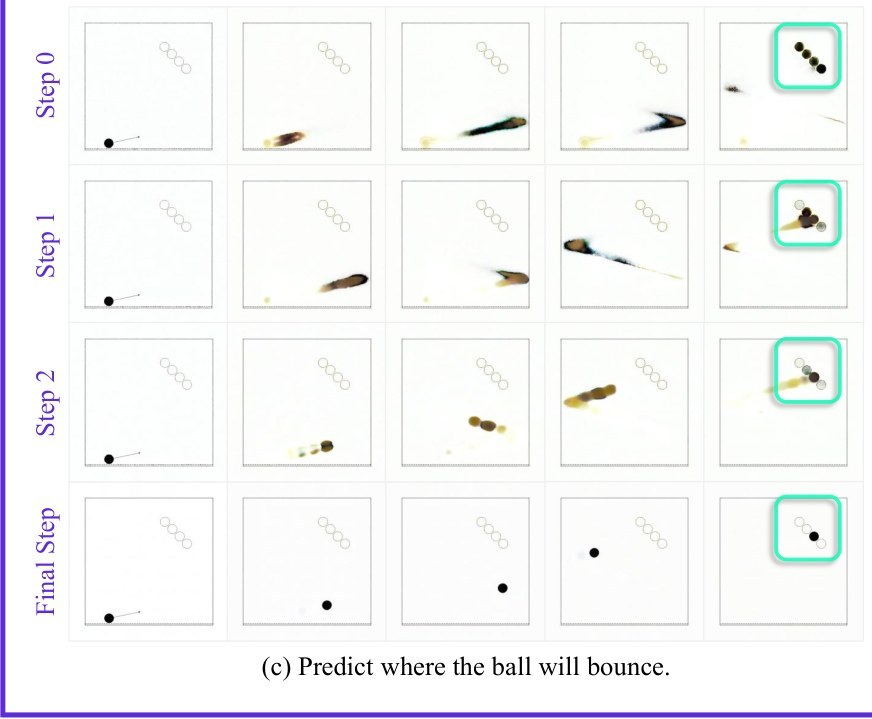
原文说模型能走错了能在中途改回来;例子都在前几步,没统计有多常见。
VGI-Bench:错改成对最多 0.9%
0.9% 就是 117 对里的 1 对,只在第 1→2、3→4 步各出现一次;第 4 步以后为 0,后半程九成不动(原文)。
变了,也多半是换成另一个错答案
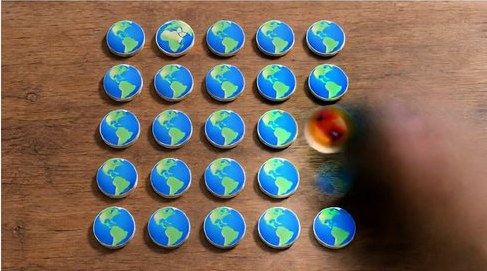
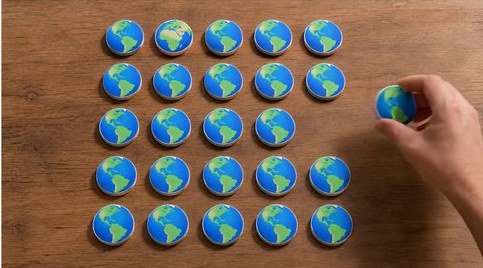
挑出唯一不同的那枚拿走:第 2 步就伸向右边一枚(错的,不同的是左上第 2 枚),最后拿走的还是它
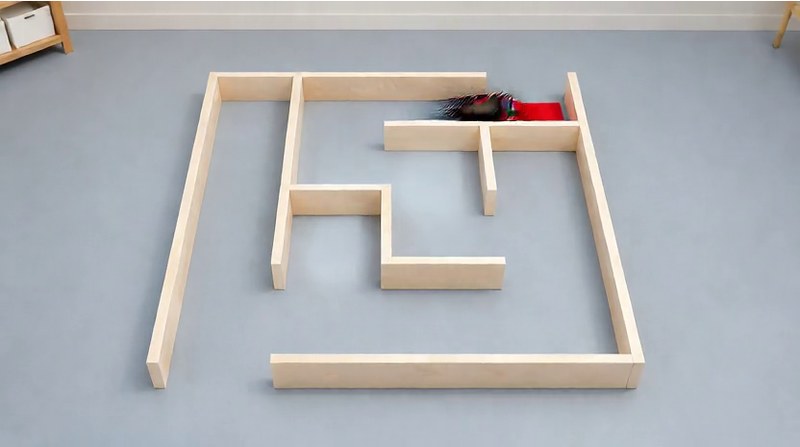
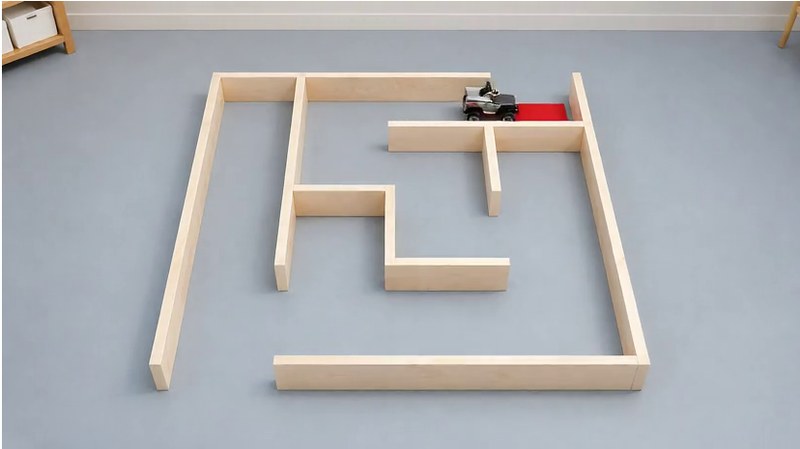
迷宫:第 3 步小车已经翻墙去够红格,最终输出是同一条翻墙路线
按表 7 换算:702 对里变了 102 次,95 次是错→另一种错,5 次对→错,2 次错→对。
两篇都看到答案在前几步就定了;第 14 篇的例子是真的,只是少见。VGI-Bench 数的是写实题,这几个模型本来就很少做对(严格成功率 Wan2.2 2.3%、VBVR-Wan2.2 11.0%),抽象题上还没人数过。
同组升级前作:题更深、换规则打分,外部基准全部超过 VBVR 版
题更深:多步题 7% → 47%
第 13 篇的 150 个任务改写保留,再新设计 150 个(数独、五子棋这类要多步搜索,任务样例)。留出 50 个任务只做测试。
迁移:别人的基准上涨得多
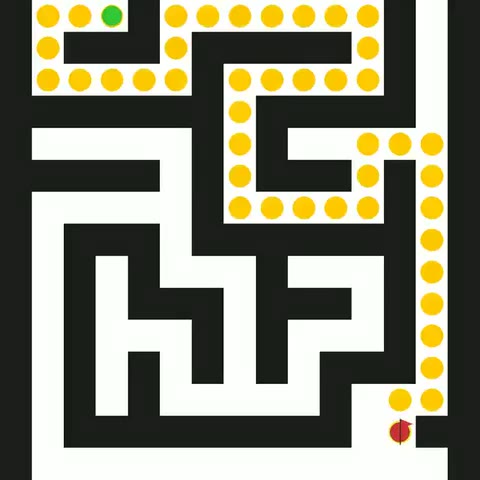
黄点画出路线
✗ 绿点没动
✗ 停在半路
到了红旗,途中跳过墙
7 个外部基准全部高于 VBVR 版,图里是涨得最多的三个;RISE-Video 只多 0.24。下排是没见过的 15×15 迷宫。
裁判:换成规则打分
VLM 裁判温度设 0 也判不稳(三种错)。规则打分当 RL 奖励,比 VLM 当奖励多涨 0.04。
loss 一路平稳下降,推理准确率却很晚才台阶式起跳
任务:从复原的 2×2×2 魔方出发,提示词给 9 步转动(例如 <F2> <L> <D2> …),模型只拿到首帧和这串动作,自己生成 80 帧;固定相机只拍到 3 个面(真值视频、模型生成的 80 帧)。从零训练 20M 到 1B 共 7 个大小的视频 DiT,每个最多看 800 万条视频,每条只用一次。
(a) Flow MSE训练 loss 本身
怎么测256 条没训过的视频,按训练条件:历史帧给真值,不让模型从头生成
读法先降后平,最后都停在 10⁻³ 附近,像标准的幂律
推断MSE 是整段 latent 的平均,决定对错的贴纸只占一小块(论文没拆)
(b) 帧准确率自己生成,12 张贴纸全对才算
怎么测100 道题 × 9 步 = 900 个停稳的画面,全靠模型自己往下画;程序按位置读颜色
读法先贴着 0,再台阶式起跳;越大起跳越晚、最后越高。0.1 PF-days 时 70M 44.6%、1B 0.3%,1B 到 3.14 才 83.7%
对照 (a)同为 150 万条视频,1B 的 MSE 比 70M 低,帧准确率却是 3.67% vs 41.00%(图 8)
(c) 全程都对9 帧都对,这道题才算对
实测只画 AR:双向模型每个检查点都是 0;AR 最好约 36%(图上读)
外推取算力前沿的中段、末段各拟合一次,到 98%:末段 248.9 PF-days(约 1.2 万 H100 小时),中段 1.425×10¹⁴,差 12 个数量级;作者说只是示意(三个指标的外推)
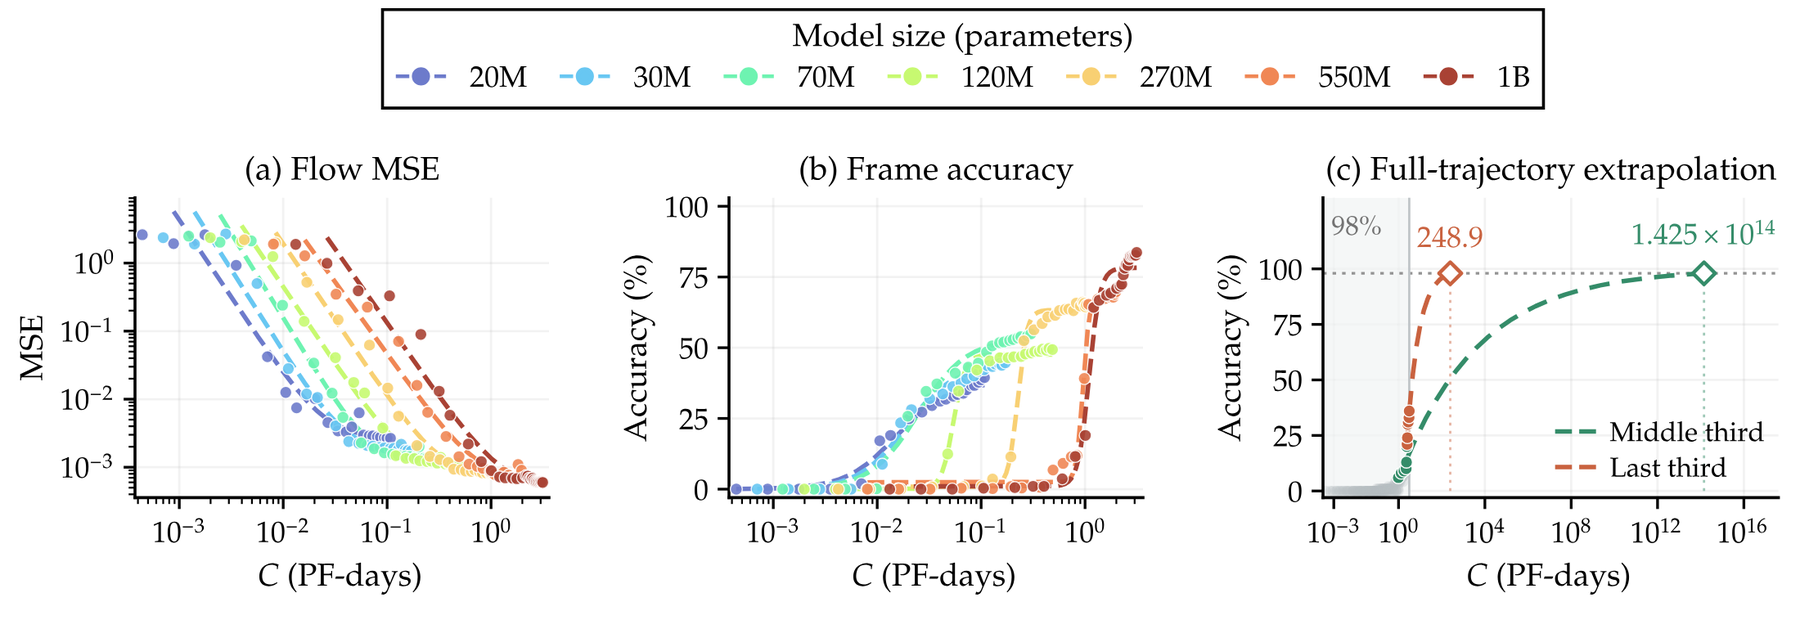 三张图横轴相同:训练算力 C(PF-days,对数刻度,每格 10 倍)。一个点是一个检查点,颜色是模型大小;大模型每条视频更贵,所以同样的视频数,点更靠右
一半贴纸看不见、答案唯一,还能把画面、动作、状态分开测
只看得见一半贴纸
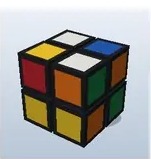
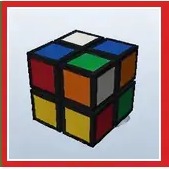
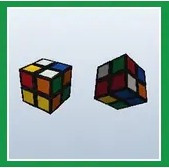
相机只拍到 12 张;一转,背面的贴纸就转到前面,要画对得记得它几步前的颜色。迷宫的墙、起点、终点全画在当前帧上(对比表)。改成同时拍前后两面,AR 第 9 步从 1% 到 88%。
答案唯一,也背不下来
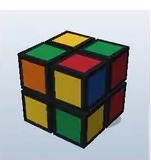
第 3 步
12/12
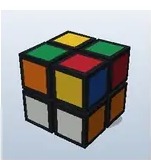
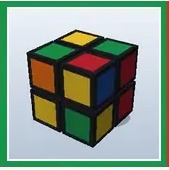
第 4 步
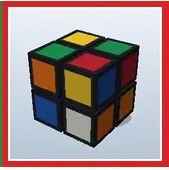
11/12
每次转动是 24 张贴纸的固定置换,首帧加动作就唯一决定之后每一帧。程序按位置读 12 张贴纸的颜色,不用 VLM 裁判(第 8 篇、第 24 篇都碰到裁判出错);真值视频经 VAE 重建后 100% 读对。
画面、动作、状态分开测
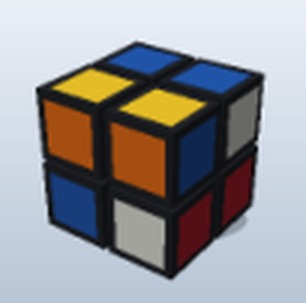
糊的
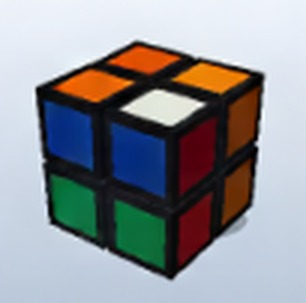
形状对、颜色错
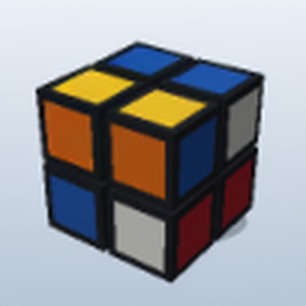
12 张全对
这道题,形状 3.4×10⁻² PF-days 就画对,12 张全对要到 5.7×10⁻¹,约 17 倍算力。只看光流、不看颜色的探针查动作:第 9 步转对 80.6%,整帧全对只有 0.3%,转对了动作,贴纸照样错。